


- 技術 💻
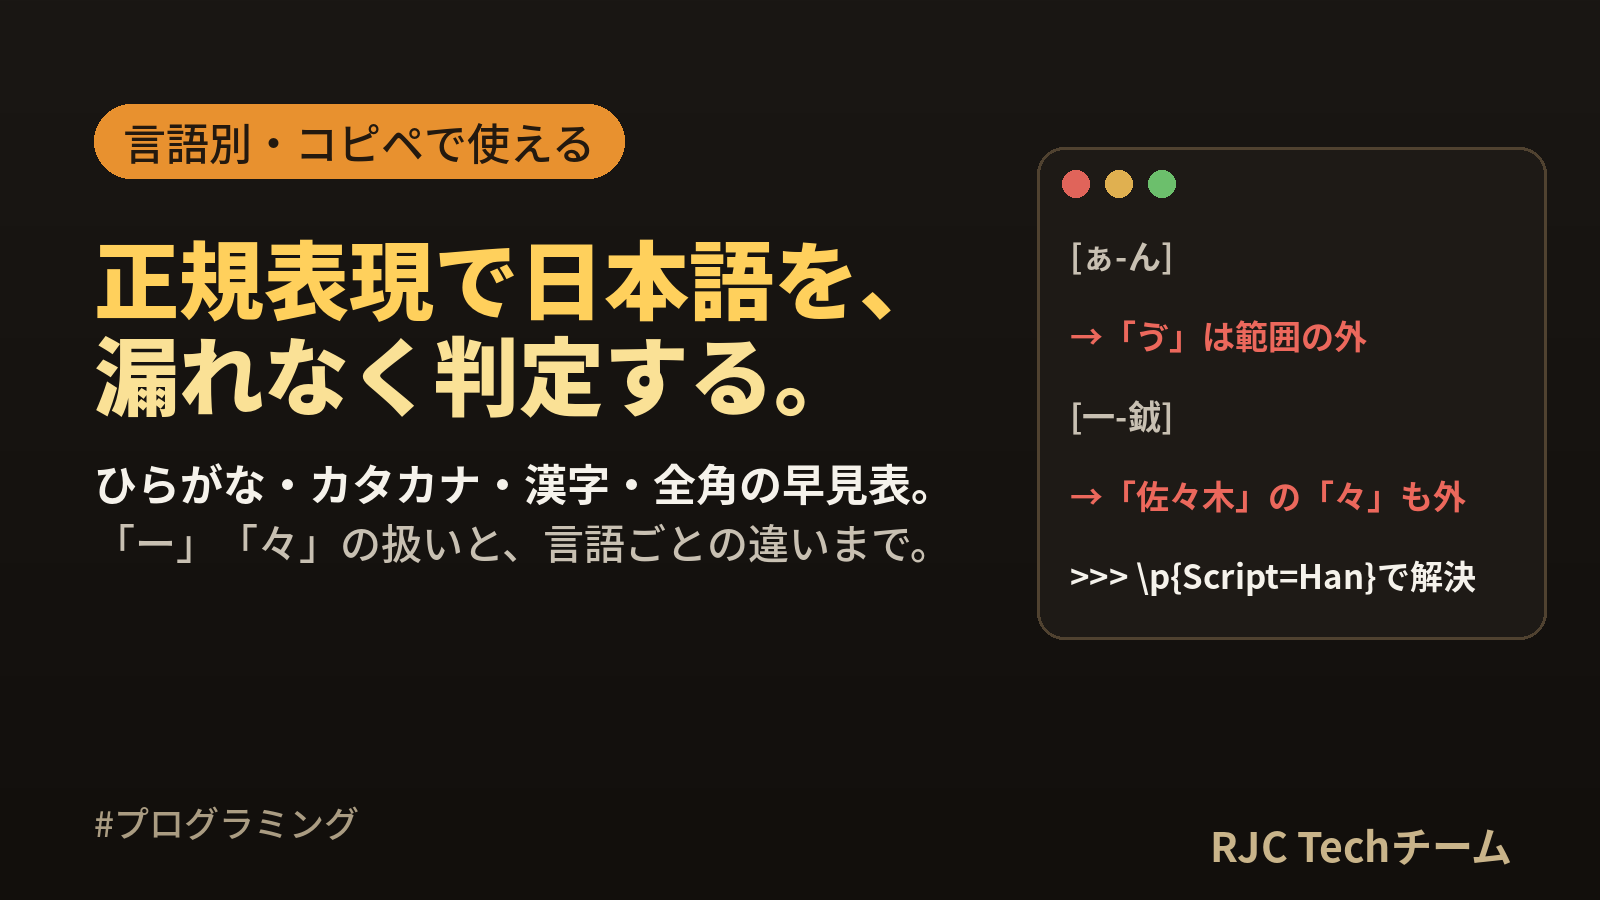
正規表現でひらがな・カタカナ・漢字を判定する方法【言語別】

正規表現でひらがなを判定するには [ぁ-ん]、カタカナは [ァ-ヶ]、漢字は [一-龯] という書き方がよく使われます。ただし、この書き方では「ゔ」「ヴ」「々」「𠮷」などが漏れます。正確に判定したい場合は、Unicodeの文字の種類(スクリプト)で指定する \p{Script=Hiragana} のような書き方を使います。
この記事では、コピーして使えるパターン早見表に加えて、よく使われる書き方で漏れる文字、長音記号「ー」の扱い、言語ごとの違い(\d が全角数字に一致するかどうか等)、入力チェックで起きやすい落とし穴までを解説します。
※文字コードはUTF-8を前提にしています。
パターン早見表
すぐに使いたい方向けに、まず一覧を示します。\p{...} の書き方は言語によって少し違うので、後の「言語別の書き方」も参照してください。
| 判定したいもの | 簡易版(範囲指定) | 正確版(Unicodeスクリプト) |
|---|---|---|
| ひらがな | [ぁ-ん] |
\p{Script=Hiragana} |
| ひらがな+長音 | [ぁ-んー] |
[\p{Script=Hiragana}ー] |
| カタカナ(全角) | [ァ-ヶ] |
\p{Script=Katakana} |
| カタカナ+長音 | [ァ-ヶー] |
[\p{Script=Katakana}ー] |
| 半角カタカナ | [ヲ-゚] |
― |
| 漢字 | [一-龯] |
\p{Script=Han} |
| 全角数字 | [0-9] |
― |
| 全角英字 | [A-Za-z] |
― |
| 半角英数字 | [A-Za-z0-9] |
― |
| 全角文字(半角以外) | [^\x01-\x7E\uFF61-\uFF9F] |
― |
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「正規表現でひらがな・カタカナ・漢字を判定する方法【言語別】」
「文字列全体がひらがなだけ」のように判定するときは、先頭と末尾を指定します。
^[ぁ-んー]+$
よく使われる書き方で漏れる文字
範囲指定は、Unicodeの文字コードの「ここからここまで」を指定する書き方です。範囲の端の選び方によって、次の文字が漏れます。
| パターン | 漏れる主な文字 | 理由 |
|---|---|---|
[ぁ-ん] |
ゔ・ゕ・ゖ・ゝ・ゞ | 「ん」より後ろのコードに配置されている |
[ァ-ン] |
ヴ・ヵ・ヶ | 「ン」より後ろのコードに配置されている |
[ァ-ヶ] |
ヷ〜ヺ・ヽ・ヾ | 「ヶ」より後ろにある |
[一-龯] |
々・𠮷・﨑・㐂 など | 々は記号の領域、𠮷は拡張領域、﨑は互換漢字の領域にある |
\p{Script=Hiragana} 単独 |
ー | 長音記号はひらがな・カタカナ共通の文字として扱われる |
\p{Script=Katakana} 単独 |
ー・・(中点) | 同上 |
特に影響が大きいのが次の3つです。
- 「ヴ」 — 「ヴィトン」「ヴァイオリン」などの表記で普通に使われるため、
[ァ-ン]だと入力を拒否してしまいます - 「々」 — 「佐々木」「野々村」など、人名や地名で頻出します。
[一-龯]では漢字と判定されません - 「𠮷」(つちよし) — 「𠮷野」など。後述するサロゲートペアの文字で、言語によっては1文字として扱われません
長音記号「ー」の扱い
「ラーメン」「すーぱー」の「ー」は、ひらがなでもカタカナでもない共通の文字として定義されています。そのため、\p{Script=Katakana} だけでは「ラーメン」がカタカナのみと判定されません。
ふりがな・フリガナの入力チェックでは、「ー」を明示的に加えるのが実務の定番です。
^[ァ-ヶー]+$                      (簡易版)
^[\p{Script=Katakana}ー]+$        (正確版)
似た見た目の文字にも注意します。「ー」(長音記号 U+30FC)・「-」(全角ハイフンマイナス)・「―」(ダッシュ)・「‐」(ハイフン)・「ー」(半角の長音)は、すべて別の文字です。入力時に混ざりやすいので、許可するかどうかを仕様として決めておきます。
言語別の書き方
\p{...} の書き方と、細かな挙動は言語によって違います。
| 言語 | ひらがなのスクリプト指定 | 必要な設定 |
|---|---|---|
| JavaScript | \p{Script=Hiragana} |
uフラグ(またはvフラグ)が必須 |
| Python | 標準の re は非対応 | regex モジュールで \p{Hiragana} |
| Java | \p{IsHiragana} |
なし |
| PHP | \p{Hiragana} |
uフラグが必須 |
| Ruby | \p{Hiragana} |
なし(UTF-8の文字列) |
| Go | \p{Hiragana} |
なし |
JavaScript
/^[\p{Script=Hiragana}ー]+$/u.test("らーめん");    // true
/^[\p{Script=Katakana}ー]+$/u.test("ヴァイオリン"); // true
/^\p{Script=Han}+$/u.test("𠮷野");                 // true
uフラグを付け忘れると、\p{...} は使えません。また、uフラグがないと「𠮷」のような文字が2文字として扱われます("𠮷".length は2)。日本語を扱う正規表現には、uフラグを付けておくのが安全です。
Python
import re
re.fullmatch(r"[ぁ-んー]+", "らーめん")        # 範囲指定なら標準のreで可

import regex   # pip install regex
regex.fullmatch(r"[\p{Hiragana}ー]+", "らーめん")
標準の re は \p{...} に対応していないため、スクリプトで判定したい場合は regex モジュールを使います。
Java
"らーめん".matches("[\\p{IsHiragana}ー]+");   // true
"佐々木".matches("\\p{IsHan}+");              // true
\p{IsHiragana} はスクリプト、\p{InHiragana} はUnicodeのブロック(文字コードの区画)での指定です。ブロック指定は区画内の未使用の位置や記号も含むため、判定にはスクリプト指定(Is)を使うのが正確です。
PHP
preg_match('/^[\p{Hiragana}ー]+$/u', 'らーめん'); // 1
uフラグがないと、文字列がバイト単位で処理されます。日本語を扱う preg_ 系関数では、uフラグを必ず付けます。
\d は全角数字に一致するか:言語で違う
入力チェックで意外と見落とされるのが、\d の範囲です。
| 言語 | \d が「5」(全角)に一致するか |
|---|---|
| JavaScript | しない |
| Java | しない(UNICODE_CHARACTER_CLASS指定時はする) |
| Python(re・文字列) | する |
| PHP(uフラグあり) | する |
| Ruby | しない |
| Go | しない |
PythonやPHPで \d を使って「半角数字のみ」をチェックしているつもりでも、全角数字や他の言語の数字が通ってしまうことがあります。半角数字だけを許可したいときは、\d ではなく [0-9] と書くのが、どの言語でも確実です(Pythonなら re.ASCII フラグでも可)。
入力チェックの落とし穴
1. 末尾の改行が通ってしまう
^...$ で全体を判定しているつもりでも、言語によっては $ が末尾の改行の直前にも一致します。
| 言語 | 「abc+改行」が ^abc$ に一致するか |
確実な書き方 |
|---|---|---|
| Python | する | re.fullmatch() を使う、または末尾に \Z |
| PHP | する | D 修飾子を付ける、または末尾に \z |
| Ruby | する(^ $ は行単位) | \A と \z を使う |
| JavaScript | しない | ^ と $ でよい |
| Java | しない(matches()は全体一致) | matches() を使う |
Rubyでは、^ $ が行の先頭・末尾を意味するため、「1行目だけ正しく、2行目に別の内容」という入力が通ってしまいます。入力チェックでは \A と \z を使います。
2. 半角カタカナの濁点は2文字
「ガ」(半角)は、「カ」と「゙」の2文字です。文字数の上限チェックや、1文字ずつの処理で結果がずれます。
3. 同じ「が」でも、2通りの表し方がある
「が」は、1文字の「が」と、「か」+結合用の濁点(U+3099)の2通りで表せます。macOSでファイル名を扱った場合などに後者が混ざり、[ぁ-ん] の判定や検索に失敗することがあります。
4. 対策:判定の前に正規化する
2と3の問題は、Unicode正規化(NFKC)で表記を揃えてから判定すると、まとめて解消できます。
import unicodedata
unicodedata.normalize("NFKC", "ガンダム ABC123")   # "ガンダム ABC123"
"ガンダム ABC123".normalize("NFKC"); // "ガンダム ABC123"
NFKCは、半角カナを全角に、全角英数字を半角に揃えます。ただし「①」が「1」、「㈱」が「(株)」になるなど、元の文字が変わるため、保存する値そのものを変えてよいかは仕様として判断します(判定用にだけ正規化する方法もあります)。
入力チェック用パターン集
実務でよく使う形にまとめました。どれも、事前にNFKCで正規化しない前提です。
| 用途 | パターン |
|---|---|
| ふりがな(ひらがな・長音・スペース) | ^[ぁ-ゖー ]+$ |
| フリガナ(カタカナ・長音・スペース) | ^[ァ-ヶー ]+$ |
| 漢字のみ(々を含む) | ^[一-龯々]+$ |
| 半角英数字のみ | ^[A-Za-z0-9]+$ |
| 半角数字のみ | ^[0-9]+$ |
| 郵便番号 | ^[0-9]{3}-?[0-9]{4}$ |
| 全角のみ | ^[^\x01-\x7E\uFF61-\uFF9F]+$ |
| 半角カタカナを含むか | [ヲ-゚] |
ぁ-ゖは、「ゔ」「ゕ」「ゖ」まで含めたひらがなの範囲ですは全角スペースと半角スペースです。姓名の間の空白を許可する場合に入れます- 漢字を厳密に判定する場合は、
[一-龯々]より\p{Script=Han}の方が漏れがありません - 「全角のみ」のパターンの
\uFF61-\uFF9Fは、PHPでは\x{FF61}-\x{FF9F}と書きます
よくある質問
Q. [ぁ-ん] と [\u3041-\u3093] は同じですか?
A. 同じ範囲です。ソースコードの文字コードの影響を受けないように、コード番号で書く方法もよく使われます。「ゔ」「ゖ」まで含めるなら [\u3041-\u3096] です。
Q. 漢字の判定で [一-龠] と [一-龯] はどちらがいいですか?
A. 「龯」の方が範囲が広く、より多くの漢字を含みます。ただし、どちらも「々」や拡張領域の漢字(𠮷など)は含まないため、正確に判定したい場合は \p{Script=Han} を使います。
Q. 全角・半角の判定はUnicodeで定義されていますか? A. 「全角」「半角」はUnicodeの厳密な分類ではなく、慣習的な呼び方です。そのため「全角」の正規表現は、「半角の英数記号と半角カタカナ以外」のように、除外で表現するのが一般的です。
Q. 絵文字はどう扱われますか? A. 多くの絵文字はサロゲートペアや、複数の文字の組み合わせで表されます。JavaScriptではuフラグがないと正しく1文字として扱われません。文字数の制限に使う場合は、言語の書記素(見た目の1文字)を数える機能を使うのが確実です。
まとめ
- ひらがなは
[ぁ-ゖ]、カタカナは[ァ-ヶ]まで含めると「ゔ」「ヴ」「ヶ」が漏れない - 正確に判定するなら
\p{Script=Hiragana}などのスクリプト指定。JavaScriptとPHPはuフラグが必須 - 長音記号「ー」はひらがな・カタカナ共通の文字。フリガナのチェックでは明示的に加える
- 漢字の
[一-龯]は「々」「𠮷」が漏れる。人名を扱うなら\p{Script=Han} \dはPython・PHPで全角数字にも一致する。半角数字は[0-9]と書く- 全体一致は、Pythonはfullmatch、Rubyは \A と \z。末尾の改行に注意する
- 半角カナや濁点の揺れは、NFKCで正規化してから判定する
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「正規表現でひらがな・カタカナ・漢字を判定する方法【言語別】」
株式会社RJCでは、保険・金融・決済などのシステムで、氏名やフリガナの入力を扱う開発に携わっています。お客様の名前を正しく受け付けることは、使いやすさと信頼の基本だと考えています。
株式会社RJC ― SI事業・SES事業・AI駆動開発。未経験からエンジニアに育てるのが得意な会社です。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




