- 技術 💻

オーバーヘッドとは?意味を場面別に|関数・通信・40ms遅延を実測


結論
オーバーヘッドとは、本来やりたい処理やデータのほかに、それを行うために余分にかかる時間・データ量・メモリ・費用のことです。IT では「処理の準備や後片付けにかかる余分なコスト」と「通信で中身に付け足すヘッダーなどの余分なデータ」の2つの意味でよく使います。経営・会計では間接費(家賃や管理部門の人件費など)を指します。
この記事でわかること
- ふだん・IT・通信・経営で違う「オーバーヘッド」の意味を1つの表で
- 関数呼び出し・プロセス起動・スレッド・コンテナ・HTTP 接続のオーバーヘッドを Python・C・シェルで実測した数値
- tcpdump で見た TCP/IP ヘッダーの割合と、Keep-Alive で起きた40ms遅延の正体、減らし方の判断表
この記事で実際に動かしたもの:Python 3.13・C(gcc 13.3)・bash 5.2 の計測プログラム、unshare による名前空間、127.0.0.1 と ip netns の中に立てた HTTP/HTTPS サーバー、tcpdump 4.99.4 によるパケットの取得、SQLite 3.53 と NumPy 2.5 の比較。
オーバーヘッドは「本来の仕事」に付いて回る余分な分です。荷物を送るときの箱や伝票、会議の前の準備のようなもので、無くすことはできませんが、何度も繰り返すと大きくなります。
flowchart TD
    A[本来の処理・データ] --> T[全体の時間・量]
    O[オーバーヘッド<br>準備・後片付け・包装] --> T
    T --> Q{回数が多い?<br>中身が小さい?}
    Q -->|はい| R[まとめる・使い回す]
    Q -->|いいえ| S[気にしなくてよい]
よく調べられることの答えを先にまとめます。
| 知りたいこと | 答え | 詳しい節 |
|---|---|---|
| オーバーヘッドとは | 本来の処理・データのほかに余分にかかる時間・データ量・費用 | オーバーヘッドとは(一言で) |
| オーバーヘッドの意味(場面別) | IT は余分な処理やヘッダー、経営は間接費、スポーツは頭上で打つこと | 場面別の意味の表 |
| 「オーバーヘッドが大きい」とは | 本来の仕事に比べて、余分な分の割合が大きいこと | 処理のオーバーヘッドを実測した一覧 |
| 関数呼び出しのオーバーヘッド | 手元では Python で1回約15ns、C で約1ns 増えた | 関数呼び出しのオーバーヘッド |
| プロセス・スレッドのオーバーヘッド | 外部コマンド1回で約1.2ms。Thread を毎回作ると1件113µs | プロセス起動とスレッド生成 |
| 通信(ヘッダー)のオーバーヘッド | 1バイト送ると線上は91バイト。1448バイトなら中身は94% | TCP/IPヘッダーの割合 |
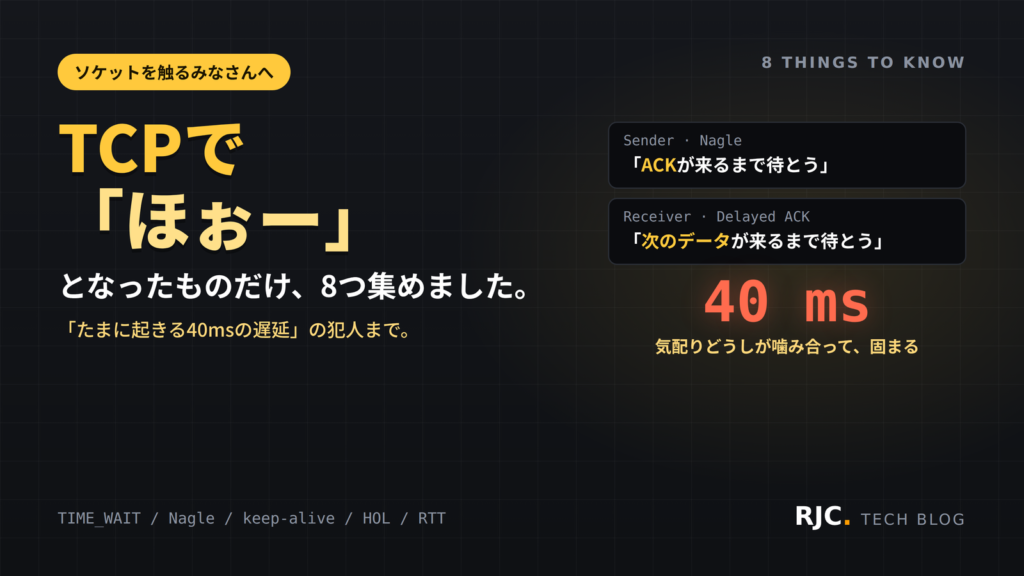
| Keep-Alive なのに遅い | Nagle と遅延 ACK が重なると毎回約40ms待つ | Keep-Aliveで遅くなった40ms |
| オーバーヘッドの減らし方 | まとめる・使い回す・回数を減らす。測ってから直す | オーバーヘッドを減らす方法 |
確認環境:Ubuntu 24.04.5 LTS(Linux 6.18・2 CPU・メモリ 8GB の仮想マシン。ほかの作業と同時に動いているため、数値はばらつきます)の作業用ディレクトリで計測しました。関数呼び出しは Python 3.13.18 の timeit と gcc 13.3.0(-O0・-O2)で、シェルは bash 5.2.21 の EPOCHREALTIME で、プロセス起動は Python の subprocess と C の fork・exec で測っています。名前空間は util-linux 2.39.3 の unshare、HTTP は Python の http.server(ThreadingHTTPServer)と http.client、HTTPS は OpenSSL 3.0.13 で作った自己署名の証明書(TLS 1.3)を 127.0.0.1 で使いました。パケットは ip netns で作った2つのネットワーク名前空間を veth(MTU 1500)でつなぎ、apt-get download した tcpdump 4.99.4(libpcap 1.10.4)の .deb を作業場所に展開して取得しています。I/O は strace 6.8、データベースは SQLite 3.53.1(Python の sqlite3)、配列は NumPy 2.5.3 で比べました。言葉の意味は IT用語辞典 e-Words と Weblio 辞書(デジタル大辞泉・IT用語辞典バイナリほか)、TCP_NODELAY は Linux の tcp(7)、Python の挙動は公式ドキュメントと標準ライブラリのソースコード、SQLite のトランザクションは SQLite 公式の FAQ、ヘッダーの大きさは各 RFC で確かめました。図は mermaid で描画を確かめています(確認日 2026年10月29日)。
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「オーバーヘッドとは?意味を場面別に|関数・通信・40ms遅延を実測」
オーバーヘッドとは(一言で・読み方・語源)
この節では、オーバーヘッドの意味を一言で言うとどうなるかと、言葉の成り立ちが分かります。
オーバーヘッド(overhead)とは、目的の処理やデータそのものではなく、それを行うために付随して余分にかかる負担のことです。IT用語辞典 e-Words は、コンピューターの処理では「処理に必要な付加的・間接的な手続き」や「余分に費やされる時間」、通信では「本来送りたい信号とは別に必要になる制御用や誤り検出・訂正用のデータ」と説明しています。デジタル大辞泉は「ある処理を実行する際に生じる付加的な作業と、それにかかる時間」としています。
- 読み方:オーバーヘッド。「オーバヘッド」と伸ばさずに書く資料もあります。
- 英語の意味:「頭上の」「頭上にあるもの」が元の意味で、そこから会計では「間接費(overhead cost)」の意味でも使われます。
- 反対の言葉:決まった対義語はありません。IT では、本来の中身を「ペイロード」、本来の処理時間を「実処理時間」などと呼んで区別します。
式で書くと、全体の時間 = 本来の処理の時間 + オーバーヘッドです。通信なら、送るデータ量 = 中身(ペイロード)+ ヘッダーなどのオーバーヘッドになります。「オーバーヘッドが大きい」とは、この右側の余分な分の割合が大きいことを言います。
宅配便にたとえると
ボールペン1本を毎回1箱で送ると、箱と伝票のほうが大きく高くつく
ヘッダーと中身の関係は、関連記事「ペイロードとは|ヘッダーとの違い・API・JWT・パケットを実物で解説」で扱っています。この記事は、そのヘッダーを含めた「余分な分」全体を、処理と通信の両方から見ます。
オーバーヘッドの意味:ふだん・IT・通信・経営の場面別の表
この節では、同じ「オーバーヘッド」が場面によって何を指すのかが、1つの表で分かります。
会話や文書で出てきたら、まず「どの場面の言葉か」を見ます。プログラムの話なら余分な処理時間、ネットワークの話ならヘッダーなどの余分なデータ、会社の数字の話なら間接費です。
| 場面 | 指すもの | 使い方の例 |
|---|---|---|
| ふだん(英語の元の意味) | 頭上・頭の上にあるもの | 飛行機の頭上の荷物入れ(overhead bin) |
| 機器の名前 | 上から映す・上に付ける機器 | オーバーヘッドプロジェクター(OHP)、オーバーヘッドカメラ(書画カメラ) |
| スポーツ | 頭より高い位置でボールを打つ・蹴ること | テニスのオーバーヘッド(スマッシュ)、サッカーのオーバーヘッドキック |
| IT・処理 | 本来の処理のほかにかかる準備・切り替え・後片付けの時間や負荷 | 関数呼び出しのオーバーヘッド、プロセス起動のオーバーヘッド |
| IT・通信 | 中身に付け足すヘッダー・制御用のデータと、その処理時間 | TCP/IP ヘッダーのオーバーヘッド、暗号化のオーバーヘッド |
| IT・メモリ・保存 | データそのもの以外に使う管理用の領域 | オブジェクトのヘッダー、ファイルシステムのブロック |
| 経営・会計 | 間接費(製品に直接結び付かない家賃・管理部門の人件費など) | オーバーヘッドコスト、研究費の間接経費 |
経営での意味は一言で言えば「間接費」です。製造業の原価計算でも、大学の研究費の「間接経費(オーバーヘッド)」でも同じ考え方で、本業を支えるが特定の製品や研究に直接割り当てられない費用を指します。この記事では、以降は IT の意味に絞って、実際に測った数値で説明します。
処理のオーバーヘッド(時間)
関数呼び出し・プロセス起動・スレッド生成
システムコール・コンテキストスイッチ
接続の確立・暗号化の握手(ハンドシェイク)
データのオーバーヘッド(量)
Ethernet・IP・TCP・UDP のヘッダー
HTTP のヘッダー
オブジェクトの管理領域・ディスクのブロック
処理のオーバーヘッドを実測した一覧(Python・C・シェル)
この節では、よく話題になるオーバーヘッドが、実際にどれくらいの大きさなのかが一覧で分かります。
オーバーヘッドの大きさは、ナノ秒(10億分の1秒)からミリ秒(1000分の1秒)まで、6桁ほど違います。同じ環境で測った代表値を並べました。数値はこの仮想マシンでの値で、ほかのマシンでは変わりますが、桁の関係はほぼ同じになります。
| オーバーヘッドの種類 | 測ったもの | 1回あたり(手元) | 詳しい節 |
|---|---|---|---|
| 関数呼び出し(C・-O2) | インライン化しない関数とする関数の差 | 約1.1ns | 関数呼び出し |
| 関数呼び出し(Python) | add(a,b) と a+b の差 |
約15ns | 関数呼び出し |
| システムコール | C の getppid() |
約120〜150ns | システムコールとI/O |
| コンテキストスイッチ | パイプで2つのプロセスが1バイトを往復 | 1往復 約4〜6µs | システムコールとI/O |
| スレッド生成 | C の pthread_create+join |
約16〜37µs | プロセス起動とスレッド生成 |
| プロセス生成 | C の fork+waitpid |
約90〜190µs | プロセス起動とスレッド生成 |
| コマンド起動 | fork+exec で /bin/true |
約1.1〜1.4ms | プロセス起動とスレッド生成 |
| 名前空間(コンテナの仕組み) | unshare で5種類を分けて起動 |
約2.5〜4ms 増える | コンテナのオーバーヘッド |
| TCP 接続 | HTTP を毎回つなぎ直す(Keep-Alive との差) | 約0.3〜0.5ms | HTTP接続のオーバーヘッド |
| TLS の握手 | HTTPS を毎回つなぎ直す(Keep-Alive との差) | 約2.6〜3.2ms | HTTP接続のオーバーヘッド |
| ディスクへのコミット | SQLite で1行ずつコミット(まとめた場合との差) | 約1.3ms | システムコールとI/O |
大切なのは「1回の大きさ」と「回数」の掛け算です。1回15ns の関数呼び出しも、1億回呼べば1.5秒になります。反対に、1回3ms の TLS の握手も、1日に数回なら全体への影響はほとんどありません。次の節から、種類ごとに測り方と結果を見ていきます。
関数呼び出しのオーバーヘッド(Python・C・シェル)
この節では、関数を呼ぶだけでどれくらい時間が増えるのかと、それが問題になる場合・ならない場合が分かります。
関数を呼ぶと、引数を渡す・戻り先を覚える・新しいフレーム(作業用の領域)を作るといった準備が増えます。この準備の分が関数呼び出しのオーバーヘッドです。
Python:1回あたり約15ns 増えた
Python 3.13 の timeit で、何もしない文・a+b・同じ計算を関数にした add(a,b) を200万回ずつ測りました(7回の最良値)。
$ python3 -m timeit -n 2000000 -r 7 -s 'pass' 'pass'
2000000 loops, best of 7: 8.88 nsec per loop
$ python3 -m timeit -n 2000000 -r 7 -s 'a=1;b=2' 'a+b'
2000000 loops, best of 7: 14.3 nsec per loop
$ python3 -m timeit -n 2000000 -r 7 -s 'def add(a,b): return a+b
a=1;b=2' 'add(a,b)'
2000000 loops, best of 7: 29.8 nsec per loop
3回くり返しても、a+b は14.3ns、add(a,b) は29.5〜30.4ns でした。関数にしただけで、1回あたり約15ns、時間がほぼ2倍になっています。何もしない文でも8.9ns かかるのは、timeit のループそのもののオーバーヘッドです。
中身が大きくなると、オーバーヘッドの割合は小さくなる
関数の中で sum(range(k)) を計算させ、k を変えて「関数で呼ぶ」「直接書く」を比べました。
| k(中身の大きさ) | 関数で呼ぶ | 直接書く | オーバーヘッドの割合 |
|---|---|---|---|
| 1 | 92.8ns | 67.4ns | 約27% |
| 10 | 140ns | 127ns | 約9% |
| 100 | 775ns | 743ns | 約4% |
| 1000 | 12.7µs | 12.5µs | 約2% |
オーバーヘッドは「1回ごとの固定費」なので、中身が大きいほど目立たなくなります。読みやすさのために関数に分けることは、ほとんどの場合、速さに影響しません。気にするのは、1回の中身がごく小さい処理を、何百万回も呼ぶ場合だけです。
C:インライン化で約1.1ns が消える
C で、足し算の関数を10億回呼びました。__attribute__((noinline)) を付けた関数は必ず呼び出し命令になり、static inline の関数は -O2 のときに呼び出し先の中身が埋め込まれます(インライン化)。
__attribute__((noinline)) long add_noinline(long a, long b){ __asm__ volatile(""); return a+b; }
static inline long add_inline(long a, long b){ return a+b; }

for (long i = 0; i < N; i++) { s = add_noinline(s, i); __asm__ volatile("" : "+r"(s)); }
$ gcc -O2 -o call_O2 call.c && ./call_O2
noinline: 1.641 s  1.64 ns/回
inline  : 0.557 s  0.56 ns/回
$ gcc -O0 -o call_O0 call.c && ./call_O0
noinline: 1.815 s  1.81 ns/回
inline  : 1.759 s  1.76 ns/回
-O2 では、インライン化した側が約1.1ns 速くなりました。-O0(最適化なし)ではインライン化されないため、ほぼ同じです。C の関数呼び出しのオーバーヘッドは Python の10分の1以下で、しかもコンパイラーが自動で消すことがあります。
シェル:外部コマンドは組み込みの約700倍
bash で同じ処理を2000回くり返し、1回あたりの時間を比べました。
bash 5.2.21(1)-release
組み込み :                  3.6 ms      1.81 µs/回
シェル関数 f               7.6 ms      3.78 µs/回
算術展開 $((i+1))           6.4 ms      3.22 µs/回
外部コマンド expr      3677.3 ms   1838.65 µs/回
外部コマンド /bin/true   2481.6 ms   1240.79 µs/回
サブシェル $(echo)       791.2 ms    395.61 µs/回
シェル関数の呼び出しは約2µs のオーバーヘッドで済みますが、外部コマンドは1回ごとに新しいプロセスを作るため、約1.2〜1.8ms かかりました。$(expr $i + 1) を $((i+1)) に書き換えるだけで、約570倍速くなります。$(echo …) のようなコマンド置換も、子プロセス(サブシェル)を作るため約0.3〜0.4ms かかりました。
小さなデータでは NumPy のほうが遅い
NumPy は1回の呼び出しに準備の時間がかかる代わりに、要素ごとの処理が速い道具です。リストの sum() と NumPy の x.sum() を、要素数を変えて比べました。
| 要素数 | list と sum() | NumPy の x.sum() | 速いほう |
|---|---|---|---|
| 10 | 97ns | 526ns | list(約5倍) |
| 1,000 | 6.01µs | 890ns | NumPy(約7倍) |
| 1,000,000 | 7.55ms | 291µs | NumPy(約26倍) |
要素が10個のときは、NumPy の呼び出しのオーバーヘッド(約0.5µs)のほうが計算より大きく、リストに負けました。「速い道具」でも、1回の中身が小さいと準備の分で負けることがあります。次の節の並列化も、同じ理屈で向き不向きが決まります。
プロセス起動とスレッド生成のオーバーヘッド
この節では、新しいプロセスやスレッドを作るのにどれくらいかかるのかと、使い回すと何が変わるのかが分かります。
プロセスを起動すると、OS がメモリの領域を用意し、プログラムを読み込み、ライブラリをつなぎ、言語の処理系なら標準モジュールを読み込みます。この準備がプロセス起動のオーバーヘッドです。
コマンドごとの起動時間
Python の subprocess から各コマンドを40回ずつ起動し、終わるまでの時間を測りました。
/bin/true                  中央値    2.35 ms  最小    1.32 ms
bash -c :                  中央値    2.70 ms  最小    2.40 ms
python3 -S -c pass         中央値   14.10 ms  最小    9.53 ms
python3 -c pass            中央値   20.06 ms  最小   13.88 ms
python3 -c 'import json'   中央値   27.48 ms  最小   21.58 ms
node -e 0                  中央値   36.27 ms  最小   26.82 ms
- 何もしない
/bin/trueでも約1.3〜2.4ms かかりました。これが「新しいプロセスを作って終わらせる」だけの最低限のオーバーヘッドです。 - Python は
-S(site モジュールを読み込まない)で約6ms 短くなり、import jsonを足すと約7ms 長くなりました。処理系の起動と import も、プログラムの中身とは別のオーバーヘッドです。 - Node.js 22 は、何もしなくても約27〜36ms かかりました。
1件ごとに python3 script.py を呼ぶバッチを1万件動かすと、起動だけで約200秒(20ms×1万)かかる計算です。1つのプロセスの中でループさせれば、この分はほぼ消えます。
C で測ったスレッド・fork・exec
$ ./th
pthread_create+join :   15.8 µs/回
fork+waitpid        :   90.3 µs/回
fork+exec(/bin/true): 1167.3 µs/回
$ ./th
pthread_create+join :   35.8 µs/回
fork+waitpid        :  148.0 µs/回
fork+exec(/bin/true): 1146.5 µs/回
同時に動いている作業によって値は変わりましたが、どの回もスレッド<fork<fork+execの順で、おおよそ10倍ずつ違いました。スレッドはプロセスのメモリを共有するため準備が少なく、exec は新しいプログラムを読み込み直すため最も重くなります。
Python:毎回作るか、使い回すか
「1を足すだけ」の小さな仕事を2000件、いろいろな方法で処理しました。
関数を直接呼ぶ                                 0.2 ms       0.1 µs/件
毎回 Thread を作って start/join             225.9 ms     113.0 µs/件
ThreadPoolExecutor(2) で使い回す            21.5 ms      10.7 µs/件
ProcessPoolExecutor(2) chunksize=1    202.2 ms     101.1 µs/件
ProcessPoolExecutor(2) chunksize=200     10.6 ms       5.3 µs/件
毎回 Process を作る(200件)                  518.0 ms    2590.0 µs/件
| 方法 | 1件あたり | 読み取れること |
|---|---|---|
| 毎回 Thread を作る | 113µs | 仕事(0.1µs)の1000倍以上が準備の時間 |
| スレッドプールで使い回す | 10.7µs | 作る回数が2回で済み、約10分の1 |
| プロセスプール(1件ずつ渡す) | 101µs | プロセス間で引数と結果を送る分が重い |
| プロセスプール(200件ずつ渡す) | 5.3µs | 送る回数を減らすと約20分の1 |
| 毎回 Process を作る | 2590µs | 最も重い。小さな仕事には向かない |
「作る」「渡す」のオーバーヘッドは、使い回す(プール)・まとめて渡す(chunksize)ことで減ります。なお、仕事が小さすぎるこの例では、どの並列化も「直接呼ぶ」の0.1µs に勝てていません。並列化は、1件の仕事がオーバーヘッドより十分に大きいときに使う道具です。Python 3.13 の Linux では multiprocessing の既定の開始方法は fork で、公式ドキュメントによると 3.14 から forkserver に変わりました。開始方法が変わると、プロセスを作るオーバーヘッドも変わります。concurrent.futures の使い分けと、仕事が大きい場合の速度比較は、関連記事「Python並列処理|concurrent.futures使い分けと速度比較」で扱っています。
コンテナのオーバーヘッド(名前空間を unshare で実測)
この節では、コンテナの仕組みである「名前空間」を作るとどれくらい遅くなるのかと、動き出したあとの速さが変わるのかが分かります。
コンテナは、Linux の名前空間(プロセス番号・マウント・ネットワークなどを分ける仕組み)と cgroup(資源の制限)で、普通のプロセスを囲ったものです。仮想マシンのように OS をまるごと起動しないため、オーバーヘッドは主に「囲いを作る」ときにかかります。Docker の本体(dockerd)はホストのネットワーク設定を書き換えるため起動せず、同じ仕組みを unshare で直接使って測りました。
各コマンドを150回ずつ、順番を毎回入れ替えて起動しました。
/bin/true(そのまま)                    中央値   1.52 ms  最小   0.96 ms
unshare -u(UTS)                    中央値   3.97 ms  最小   1.91 ms
unshare -m(mount)                  中央値   4.59 ms  最小   2.03 ms
unshare -n(network)                中央値   4.32 ms  最小   2.21 ms
unshare -p -f --mount-proc         中央値   5.12 ms  最小   2.19 ms
unshare -muinp -f --mount-proc     中央値   5.77 ms  最小   2.50 ms
名前空間を5種類(mount・UTS・IPC・network・PID)分けても、起動のオーバーヘッドは中央値で約4msでした。unshare というプログラムを1つ余分に起動する分も含みます。
次に、4億回の足し算をする C のプログラムを、そのままと、5種類の名前空間の中で3回ずつ動かしました。
host: 0.365 s
ns  : 0.155 s
host: 0.242 s
ns  : 0.177 s
host: 0.238 s
ns  : 0.346 s
どちらが速いかは回ごとに入れ替わり、差は測定のばらつきの範囲でした。計算そのものは、名前空間の中でも同じ CPU の命令がそのまま動くため、遅くなりません。コンテナのオーバーヘッドが問題になりやすいのは、起動の回数が多いとき、ネットワークを NAT やブリッジで中継するとき、重ねたファイルシステム(overlayfs)に細かい書き込みが多いときです。後の2つはこの記事では測っていません。
- 1起動の回数を数える1件ごとにコンテナを起動する作りなら、起動の数ms〜数秒が件数分かかる
- 2計算が中心なら気にしない手元では、名前空間の中と外で計算の時間に差は出なかった
- 3ネットワークと書き込みは別に測る中継の方式・保存先の種類で変わる。自分の構成で測ってから判断する
システムコールとI/Oのオーバーヘッド(バッファリングとコミット)
この節では、OS に頼む操作(システムコール)やディスクへの確定(コミット)の回数が、速さにどう効くのかが分かります。
ファイルへの書き込みや画面への出力は、プログラムが OS(カーネル)に頼んで行います。この頼みごとがシステムコールで、1回ごとにユーザーの領域とカーネルの領域を行き来するオーバーヘッドがかかります。C の getppid()(親プロセスの番号を聞くだけのシステムコール)は1回約120〜150ns、パイプで2つのプロセスが1バイトを往復させると、プロセスの切り替え(コンテキストスイッチ)を2回含んで約4〜6µs でした。
1バイトずつ書くか、まとめて書くか
Python で20万バイトを3通りの方法でファイルに書きました。
with open(p, "wb", buffering=0) as f:    # バッファなし:write のたびにシステムコール
    for _ in range(N): f.write(b"x")
with open(p, "wb") as f:                 # 既定:バッファにためてから書く
    for _ in range(N): f.write(b"x")
with open(p, "wb") as f:                 # まとめて1回
    f.write(b"x" * N)
buffering=0(1バイトずつwrite)          110.9 ms
既定のバッファあり                          22.2 ms
まとめて1回                              0.3 ms
strace でシステムコールの回数を数えると、違いの理由が分かります。
== buffering=0
100.00    0.683492           3    200001           write
== 既定のバッファあり
100.00    0.000010           0        50           write
== まとめて1回
100.00    0.000034          17         2           write
バッファなしでは write が20万1回、既定では50回でした。このファイルのブロックの大きさ(st_blksize)は4096バイトで、20万÷4096≒49回に、最後の出力の1回を足した数です。Python のループ自体のオーバーヘッドが残るため、「バッファあり」でも「まとめて1回」より遅くなっています。
なお、strace を付けて測ると、バッファなしの書き込みは約110ms から約4.3秒に延びました。計測の道具そのものにもオーバーヘッドがあり、測っているものを遅くします。回数を数えるときは strace、時間を測るときは strace を外す、と分けて使います。計測の注意点は関連記事「ベンチマークの落とし穴8選|JMH・p99・ウォームアップ」で扱っています。
SQLite:1行ずつコミットすると約380倍遅い
2000行を SQLite に入れる時間を比べました。
sqlite 3.53.1
1行ごとにコミット                      2648.3 ms   1324.2 µs/行
1つのトランザクション                       7.0 ms      3.5 µs/行
executemany+1トランザクション             4.6 ms      2.3 µs/行
1行ごとにコミットすると、1行あたり約1.3ms、まとめた場合の約380倍かかりました。SQLite 公式の FAQ は、既定では INSERT が1つずつ独立したトランザクションになり、データが安全にディスクへ書かれるまで待つため遅くなること、BEGIN…COMMIT で囲むとコミットの時間が中の INSERT 全体に割り振られて1文あたりの時間が大きく減ることを説明しています。ほかのデータベースでも、ネットワークの往復やコミットの回数は同じ考え方で効きます。
HTTP接続のオーバーヘッド(Keep-Alive・TLSの握手)
この節では、HTTP で毎回つなぎ直すと何が増えるのかと、Keep-Alive で接続を使い回したときの差が分かります。
HTTP で通信するには、まず TCP の接続(3ウェイハンドシェイク)を作り、HTTPS ならさらに TLS の握手で鍵を決めます。この準備は、送りたいリクエストとは別のオーバーヘッドです。Keep-Alive(持続的接続)は、一度作った接続を次のリクエストでも使い回す仕組みです。
127.0.0.1 に HTTP と HTTPS(TLS 1.3)のサーバーを立て、Python の http.client で300件ずつ送りました(後で説明する TCP_NODELAY を設定したサーバー)。
HTTP  毎回つなぎ直す                           179.9 ms   0.600 ms/件
HTTP  Keep-Alive                         79.2 ms   0.264 ms/件
HTTPS 毎回つなぎ直す(TLS1.3)                   832.0 ms   2.773 ms/件
HTTPS Keep-Alive                         59.0 ms   0.197 ms/件
HTTP  毎回つなぎ直す                           199.0 ms   0.663 ms/件
HTTP  Keep-Alive                         42.8 ms   0.143 ms/件
HTTPS 毎回つなぎ直す(TLS1.3)                  1020.6 ms   3.402 ms/件
HTTPS Keep-Alive                         47.4 ms   0.158 ms/件
| 方法 | 1件あたり | Keep-Alive との差(接続のオーバーヘッド) |
|---|---|---|
| HTTP・毎回つなぎ直す | 0.60〜0.66ms | 約0.3〜0.5ms(TCP の接続と切断) |
| HTTP・Keep-Alive | 0.14〜0.26ms | ― |
| HTTPS・毎回つなぎ直す | 2.8〜3.4ms | 約2.6〜3.2ms(TCP+TLS の握手) |
| HTTPS・Keep-Alive | 0.16〜0.20ms | ― |
HTTPS を毎回つなぎ直すと、1件あたりの時間が約14〜22倍になりました。127.0.0.1 は往復の遅れがほぼ0なので、この差は TLS の鍵交換・証明書の検証の計算の分です。実際のネットワークでは、さらに往復の回数分(TCP で1往復、TLS 1.3 で1往復)の遅れが加わります。Keep-Alive で使い回すと、HTTPS でも HTTP とほぼ同じ速さになりました。
通信の遅れ(レイテンシ)の大きさごとの影響は、関連記事「レイテンシとは|意味・目安・測り方を遅延0〜300msの実測で解説」で扱っています。往復の遅れが大きいほど、接続のオーバーヘッドの差も大きくなります。
Keep-Aliveで遅くなった40ms(Nagleと遅延ACKをtcpdumpで見る)
この節では、接続を使い回したのに逆に遅くなった実例と、その原因をパケットで確かめた結果が分かります。
最初に何も設定しないサーバーで測ったところ、Keep-Alive のほうが毎回つなぎ直すより約70倍遅くなりました。
HTTP  毎回つなぎ直す                     322.9 ms   0.646 ms/件
HTTP  Keep-Alive で使い回す          22067.3 ms  44.135 ms/件
HTTPS 毎回つなぎ直す(TLS1.3)           22588.5 ms  45.177 ms/件
HTTPS Keep-Alive で使い回す          22208.0 ms  44.416 ms/件
1件あたり約44ms で、ほぼ一定です。2つのネットワーク名前空間を veth でつなぎ、同じサーバーに Keep-Alive で4回リクエストを送ると、1回目だけ速く、2回目から約40ms かかりました。
1回目   2.40 ms
2回目  40.74 ms
3回目  45.15 ms
4回目  43.62 ms
tcpdump の原文です(-ttt で、前のパケットからの経過時間を表示。オプションの欄を省いています)。2回目のリクエストの部分です。
 00:00:00.000332 IP 10.201.0.1.41972 > 10.201.0.2.8080: Flags [P.], seq 69:137, ack 142, length 68: HTTP: GET / HTTP/1.1
 00:00:00.000226 IP 10.201.0.2.8080 > 10.201.0.1.41972: Flags [P.], seq 142:280, ack 137, length 138: HTTP: HTTP/1.1 200 OK
 00:00:00.040325 IP 10.201.0.1.41972 > 10.201.0.2.8080: Flags [.], ack 280, length 0
 00:00:00.000034 IP 10.201.0.2.8080 > 10.201.0.1.41972: Flags [P.], seq 280:283, ack 137, length 3: HTTP
 00:00:00.000006 IP 10.201.0.1.41972 > 10.201.0.2.8080: Flags [.], ack 283, length 0
sequenceDiagram
    participant C as クライアント
    participant S as サーバー
    C->>S: GET(68バイト)
    S->>C: ヘッダー(138バイト)
    Note over S: 本文3バイトは<br>ACKまで待つ(Nagle)
    Note over C: ACKを遅らせる<br>(遅延ACK)
    C->>S: 約40ms後にACK
    S->>C: 本文(3バイト)
- サーバーは、応答のヘッダー(138バイト)と本文(3バイト)を、別々の write で送っていた。
- ヘッダーを送ったあと、まだ ACK(受け取りの返事)が来ていないので、Nagle のアルゴリズム(小さなパケットをためて送る仕組み)が本文の送信を待たせた。
- クライアントは、返事をまとめて送るために ACK を少し遅らせる(遅延 ACK)。Linux では約40ms 遅れた。
- 40ms 後に ACK が届いてから、やっと本文の3バイトが送られた。
つなぎ直した直後の1回目は遅延が出ませんでした。接続を作った直後の Linux はすぐに ACK を返すため(tcp(7) の quickack モード)と考えられます。そのため「毎回つなぎ直す」ほうが速く見えたのです。
直し方:まとめて1回で送るか、TCP_NODELAY
| 直し方 | やったこと | 2〜4回目の時間 |
|---|---|---|
| 何もしない | ― | 40.7・45.2・43.6ms |
| TCP_NODELAY | ハンドラーに disable_nagle_algorithm = True |
0.34・0.19・0.20ms |
| まとめて1回で送る | ハンドラーに wbufsize = -1(書き込みをバッファする) |
0.24・0.46・0.34ms |
Linux の tcp(7) は、TCP_NODELAY について「設定すると Nagle のアルゴリズムを無効にする」「少量のデータでも、セグメントはできるだけ早く送られる」と説明しています。Python の socketserver のソースコードでは、disable_nagle_algorithm が True のときに接続へ TCP_NODELAY を設定し、コメントに「小さなパケットを避けるため、wbufsize が0でないときだけ使う」と書かれていました。根本の直し方は「小さな write を何度もせず、まとめて1回で送る」ことで、TCP_NODELAY はそれと組み合わせて使います。
class H(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    wbufsize = -1                    # ヘッダーと本文をまとめて1回で送る
    disable_nagle_algorithm = True   # TCP_NODELAY(小さな送信を待たせない)
この40ms の遅れは、TCP の有名な落とし穴の1つです。TIME_WAIT などほかの落とし穴は、関連記事「TCPの落とし穴8選|TIME_WAIT・40ms遅延の正体」で扱っています。
通信のオーバーヘッド:TCP/IPヘッダーの割合(計算とtcpdump)
この節では、データを送るときに中身以外に何バイト付くのかと、中身の大きさで割合がどう変わるのかが分かります。
ネットワークで送るデータには、宛先や順番を書いたヘッダーが層ごとに付きます。中身が小さいほど、ヘッダーの割合(通信のオーバーヘッド)が大きくなります。
| 層 | 付くもの | 大きさ(バイト) |
|---|---|---|
| Ethernet(線上) | プリアンブル+SFD、フレーム間のすき間 | 8+12 |
| Ethernet(フレーム) | ヘッダー、末尾の FCS(誤り検出) | 14+4 |
| IPv4 | IP ヘッダー(オプションなし) | 20 |
| TCP | TCP ヘッダー+タイムスタンプのオプション | 20+12 |
| UDP | UDP ヘッダー | 8 |
ネットワーク名前空間の間で、TCP(TCP_NODELAY)で1・100・1000・1448・3000バイト、UDP で1・1472バイトを送り、tcpdump の -e -v で取得しました(チェックサムなどの欄を省いています)。
ethertype IPv4 (0x0800), length 67: (... proto TCP (6), length 53)
    10.201.0.1.45922 > 10.201.0.2.9000: Flags [P.], seq 1:2, ack 1, win 63, options [nop,nop,TS val 1619656688 ecr 4007894857], length 1
ethertype IPv4 (0x0800), length 166: (... proto TCP (6), length 152)
    10.201.0.1.45922 > 10.201.0.2.9000: Flags [P.], seq 2:102, ... length 100
ethertype IPv4 (0x0800), length 1066: (... proto TCP (6), length 1052)
    10.201.0.1.45922 > 10.201.0.2.9000: Flags [P.], seq 102:1102, ... length 1000
ethertype IPv4 (0x0800), length 1514: (... proto TCP (6), length 1500)
    10.201.0.1.45922 > 10.201.0.2.9000: Flags [P.], seq 1102:2550, ... length 1448
ethertype IPv4 (0x0800), length 43: (... proto UDP (17), length 29)
    10.201.0.1.45407 > 10.201.0.2.9001: UDP, length 1
ethertype IPv4 (0x0800), length 1514: (... proto UDP (17), length 1500)
    10.201.0.1.45407 > 10.201.0.2.9001: UDP, length 1472
1行目の length 67 が Ethernet のフレーム(FCS を除く)、proto TCP (6), length 53 が IP パケット、最後の length 1 が中身です。67=14(Ethernet)+20(IP)+32(TCP とオプション)+1 で、計算と一致しました。この値に、線上で付く FCS・プリアンブル・すき間を足して割合を出しました。
| 送った中身 | tcpdump の length | 線上のバイト数 | 中身の割合 |
|---|---|---|---|
| TCP 1バイト | 67 | 91 | 1.1% |
| TCP 100バイト | 166 | 190 | 52.6% |
| TCP 1000バイト | 1066 | 1090 | 91.7% |
| TCP 1448バイト | 1514 | 1538 | 94.1% |
| UDP 1バイト | 43 | 84(60バイトまで詰め物) | 1.2% |
| UDP 1472バイト | 1514 | 1538 | 95.7% |
- 1バイトを送ると、線上では91バイトになり、中身は約1%でした。キー入力を1文字ずつ送るような通信は、ほとんどがヘッダーです。
- MTU 1500 のとき、TCP(タイムスタンプあり)で1パケットに入る中身は最大1448バイトで、中身の割合は約94%が上限です。1Gbps の回線でも、TCP で運べる中身は最大で約941Mbps(1Gbps×94.1%)になります。
- UDP の1バイトは、Ethernet の最小フレーム(FCS を含め64バイト)に満たないため、送るときに詰め物が足されます。tcpdump は詰め物を足す前を見るため、43と表示されました。
- 3000バイトを1回で送ると、tcpdump には
length 3066の1つの大きなパケットとして見えました。これは送信側のオフロード(GSO)で、まとめたまま渡しているためで、線上では1448・1448・104バイトの3つに分かれます。
HTTP のヘッダーもオーバーヘッド
前の節の tcpdump では、本文3バイトの応答に、138バイトの HTTP ヘッダーが付いていました。リクエストの GET / HTTP/1.1 も68バイトです。小さな JSON を返す API を細かく何度も呼ぶと、送る量の大半がヘッダーになります。HTTP/2 や HTTP/3 はヘッダーを圧縮してこの分を減らします。
メモリとストレージのオーバーヘッド
この節では、データを置くときに、中身以外にどれくらいの領域を使うのかが分かります。
Python の整数は1個40バイト
int 1 : 28 bytes
float : 24 bytes
空のlist: 56  空のdict: 64  空のstr: 41
list[int] 100万個        40.0 MB  1個あたり  40.0 バイト(中身は8バイト)
array('q') 100万個        8.2 MB  1個あたり   8.2 バイト(中身は8バイト)
bytes 8×100万            8.0 MB  1個あたり   8.0 バイト(中身は8バイト)
Python のリストに整数を100万個入れると約40MB、中身の8バイトに対して1個あたり40バイト使いました。Python の整数はそれぞれがオブジェクトで、型の情報や参照の数を持つヘッダーが付き、リストはそのオブジェクトへの参照(8バイト)を持つためです。array('q') や NumPy の配列は数値を詰めて並べるため、ほぼ中身の大きさで済みました。
1バイトのファイルも4KB 使う
中身の合計: 1000 bytes
$ du -sh --apparent-size .
1000	.
$ du -sh .
4.0M	.
$ stat -c '%s bytes / %b blocks of %B' f1
1 bytes / 8 blocks of 512
ext4 の上に1バイトのファイルを1000個作ると、中身は合計1000バイトなのに、ディスクの使用量は4.0MBでした。ファイルは4096バイトのブロック単位で場所を取るため、1バイトのファイルでも1ブロックを使います。小さなファイルを大量に作るより、1つのファイルやデータベースにまとめたほうが、領域の点でもオーバーヘッドが小さくなります。
オブジェクトのヘッダー
Python の int は28バイト。リストからの参照を含めると1個40バイト。
数値の大量保持は配列に
ファイルのブロック
1バイトのファイルでも4KB。1000個で4MB。
小さなファイルはまとめる
通信のヘッダー
1バイトの中身に90バイトの包装。
まとめて送る
処理の準備
プロセス起動・接続・コミットは1回ごとの固定費。
使い回す・まとめる
オーバーヘッドを減らす方法(判断表)
この節では、オーバーヘッドが問題になったときに、どの順番で何を試せばよいかが分かります。
オーバーヘッドを減らす方法は、ほぼ「回数を減らす」「使い回す」「まとめる」の3つです。ただし、減らす前に「本当にオーバーヘッドが原因か」を測って確かめます。
- 1測る:全体の時間と回数を見る1回の大きさ×回数で、どこが大きいかを先に知る
- 2回数を減らす:ループの中の重い呼び出しを外へ外部コマンド→組み込み、1件ごとの起動→1プロセスでループ
- 3使い回す:作り直さないスレッドプール・コネクションプール・Keep-Alive
- 4まとめる:小さな単位を大きくするバッファリング・トランザクション・バッチ API・chunksize
- 5道具を変える:1回の固定費が小さいものへ要素数が多いなら NumPy、少ないなら素のリスト
| 症状 | 疑うオーバーヘッド | 手元で効いた対策 | 効果(手元) |
|---|---|---|---|
| シェルスクリプトのループが遅い | 外部コマンドの起動 | $(expr …) を $((…)) に |
約570倍 |
| 1件ごとにスクリプトを起動するバッチが遅い | 処理系の起動・import | 1つのプロセスでループする | 1件約20ms が消える |
| スレッドを作る処理が遅い | スレッド生成 | ThreadPoolExecutor で使い回す | 約10倍 |
| プロセス並列が直列より遅い | プロセス間の受け渡し | chunksize で200件ずつ渡す | 約19倍 |
| ファイル出力が遅い | システムコール | バッファリング・まとめて write | 約5〜370倍 |
| DB への登録が遅い | コミット | 1つのトランザクションにまとめる | 約380倍 |
| API 呼び出しが1件数ms かかる | TCP・TLS の接続 | Keep-Alive・コネクションプール | HTTPS で約14〜22倍 |
| Keep-Alive なのに1件40ms | Nagle と遅延 ACK | まとめて送る・TCP_NODELAY | 約40ms→0.2〜0.5ms |
やってはいけない → 代わりに
回数×1回の大きさが小さいオーバーヘッドは、読みやすさを優先する
1固定費は回数で効く
1回15ns でも1億回で1.5秒。1回3ms でも1日数回なら影響しない。
2中身が小さいと目立つ
1バイトの通信は中身1%。10要素の NumPy はリストに負けた。
3減らすと増えるものもある
まとめると待ち時間(レイテンシ)が増える。バッファは落ちたときに失う分が増える。
最後のカードのとおり、オーバーヘッドを減らす工夫には代わりの負担があります。Nagle のアルゴリズムも、もともと「小さなパケットのヘッダーのオーバーヘッドを減らす」ための仕組みで、その代わりに待ち時間が増えたのが前の節の40ms でした。スループット(量)を取るか、レイテンシ(待ち時間)を取るかを決めてから、まとめる量を選びます。
よくある誤解とつまずき(エラー・症状の原文つき)
この節では、オーバーヘッドを調べたり減らしたりするときに、つまずきやすい点が分かります。
| 症状・原文 | 原因 | 直し方 |
|---|---|---|
Keep-Alive にしたら1件 44.135 ms/件 に遅くなった |
小さな write が2回に分かれ、Nagle と遅延 ACK が重なった | 応答をまとめて1回で送る。必要なら TCP_NODELAY |
tcpdump に cksum 0x15c3 (incorrect -> 0xd65e) |
チェックサムの計算を後の段階(オフロード)に任せているため、取得した時点では未計算 | 送信側で取得したときは正常。受信側でも出るなら調べる |
tcpdump に MTU より大きい length 3066 |
GSO で分割前のまとまりを見ている | 線上では1448バイトずつに分かれる。割合の計算は分割後で行う |
strace を付けたら 4298.8 ms に遅くなった |
strace がシステムコールのたびに止めて記録するオーバーヘッド | 回数を数えるときだけ使い、時間は strace なしで測る |
tcpdump: Couldn't find user 'tcpdump' |
.deb を展開しただけで、権限を下げる先のユーザーが無い | 作業用の環境では -Z root を付ける(公開の環境では専用ユーザーを作る) |
| プロセス並列にしたら直列より遅い | 1件の仕事が小さく、受け渡しのオーバーヘッドのほうが大きい | chunksize で大きくまとめる。小さすぎる仕事は並列化しない |
| 計測するたびに数値が2倍近く変わる | ほかの処理の影響・CPU の周波数・キャッシュ | 何回か測り、最小値か中央値で比べる。順番を入れ替える |
- 「コンテナは遅い」とは限りません。手元では、名前空間の中でも計算の時間は変わりませんでした。遅く感じるときは、起動の回数・ネットワークの中継・保存先を分けて調べます。
- 「オーバーヘッド=無駄」ではありません。TCP のヘッダーは届いたかの確認と順番の並べ直しに、TLS の握手は盗み見と改ざんを防ぐために必要です。減らすのは「同じ準備を何度もくり返している分」です。
- Python が遅いのは、主に1命令ごとのオーバーヘッドが大きいためです。C の関数呼び出し約1ns に対し Python は約15ns でした。ループを NumPy や組み込み関数(
sum()は手元で約3倍速い)に任せると、このオーバーヘッドを C の側で1回にまとめられます。
よくある質問
Q. オーバーヘッドとは簡単に言うと何ですか? A. 本来やりたい処理やデータのほかに、それを行うために余分にかかる時間・データ量・費用のことです。荷物を送るときの箱や伝票にあたります。
Q. 「オーバーヘッドが大きい」とはどういう意味ですか? A. 本来の仕事に比べて、準備や包装などの余分な分の割合が大きいことです。1バイトのデータを TCP で送ると線上では91バイトになり、オーバーヘッドが約99%を占めました。
Q. ビジネスでのオーバーヘッドとは? A. 間接費のことです。家賃・光熱費・管理部門の人件費など、特定の製品やサービスに直接割り当てられない費用を指し、「オーバーヘッドコスト」とも言います。
Q. 関数呼び出しのオーバーヘッドは気にするべきですか? A. ほとんどの場合、気にしなくて済みます。手元では Python で1回約15ns、C で約1ns で、中身が数百ns 以上ある関数なら割合は数%以下でした。中身がごく小さい関数を何百万回も呼ぶループだけ、測ってから考えます。
Q. プロセスとスレッドでは、どちらのオーバーヘッドが大きいですか? A. プロセスです。C で測ると、スレッドの生成は約16〜37µs、fork は約90〜190µs、fork と exec でコマンドを起動すると約1.1〜1.4ms でした。
Q. コンテナのオーバーヘッドはどれくらいですか? A. unshare で名前空間を5種類分けて起動すると、中央値で約4ms 増えました。動き出したあとの計算の速さは変わりませんでした。Docker などの道具では、イメージの準備やネットワークの設定の分がさらに加わります。
Q. 通信のオーバーヘッドを減らすには? A. 小さなデータを何度も送らず、まとめて送ります。HTTP なら Keep-Alive やコネクションプールで接続を使い回し、API なら複数の件をまとめて送れる形にします。HTTP/2・HTTP/3 はヘッダーの圧縮でも減らします。
Q. Keep-Alive にしたのに遅くなりました。 A. 応答を小さな write に分けて送っていると、Nagle のアルゴリズムと遅延 ACK が重なり、毎回約40ms 待つことがあります。手元では、応答をまとめて1回で送るか、TCP_NODELAY を設定すると0.2〜0.5ms に戻りました。
Q. オーバーヘッドとレイテンシの違いは? A. レイテンシは「頼んでから結果が返るまでの待ち時間」で、オーバーヘッドは「本来の処理以外に余分にかかる分」です。接続の確立のように、オーバーヘッドがレイテンシの一部になることがあります。
Q. オーバーヘッドの測り方は?
A. 「本来の処理だけ」と「余分な処理を含む」を同じ条件で何回か測り、差を取ります。Python なら timeit、シェルなら EPOCHREALTIME、システムコールの回数なら strace -c、通信なら tcpdump で長さと時刻を見ます。
Q. オーバーヘッドの対義語はありますか? A. 決まった対義語はありません。通信では本来の中身を「ペイロード」、処理では本来の仕事を「実処理」などと呼んで区別します。
まとめ
- オーバーヘッドとは、本来の処理やデータのほかに余分にかかる時間・データ量・メモリ・費用のこと。IT では処理の準備と通信のヘッダー、経営では間接費を指す。
- 大きさは種類で6桁違う。手元では C の関数呼び出し約1ns、Python 約15ns、システムコール約0.1µs、スレッド生成約16〜37µs、コマンド起動約1.2ms、TLS の握手約3ms だった。
- オーバーヘッドは1回ごとの固定費なので、「1回の大きさ×回数」と「中身との比」で影響が決まる。中身が大きい処理では目立たない。
- 通信では、1バイトの中身が線上で91バイトになり、MTU 1500 の TCP で中身の割合は最大約94%。Keep-Alive では、Nagle と遅延 ACK が重なって1件約40ms 待つことがあり、まとめて送ると解消した。
- 減らし方は「測る→回数を減らす→使い回す→まとめる→道具を変える」の順。まとめるとレイテンシや失う分が増えるため、何を優先するかを決めてから選ぶ。
次に読むとよい記事です。「コンテキスト」のように場面で意味が変わる IT の言葉は、関連記事「コンテキストとは|IT・プログラミング・AIでの意味を分野別に実演」で扱っています。
参考・出典
確認日はいずれも 2026年10月29日です。
- IT用語辞典 e-Words「オーバーヘッド」:https://e-words.jp/w/オーバーヘッド.html
- Weblio 辞書「オーバーヘッド」(デジタル大辞泉・IT用語辞典バイナリ ほか):https://www.weblio.jp/content/オーバーヘッド
- Linux man-pages「tcp(7)」(TCP_NODELAY・TCP_QUICKACK):https://man7.org/linux/man-pages/man7/tcp.7.html
- Python ドキュメント「multiprocessing」(Contexts and start methods):https://docs.python.org/3/library/multiprocessing.html
- Python ドキュメント「socketserver」:https://docs.python.org/3/library/socketserver.html
- Python ドキュメント「timeit」:https://docs.python.org/3/library/timeit.html
- SQLite「Frequently Asked Questions」(19. INSERT is really slow):https://www.sqlite.org/faq.html
- IETF「RFC 791 Internet Protocol」:https://www.rfc-editor.org/rfc/rfc791
- IETF「RFC 9293 Transmission Control Protocol (TCP)」:https://www.rfc-editor.org/rfc/rfc9293
- IETF「RFC 768 User Datagram Protocol」:https://www.rfc-editor.org/rfc/rfc768
- IETF「RFC 7323 TCP Extensions for High Performance」(タイムスタンプのオプション):https://www.rfc-editor.org/rfc/rfc7323
- IETF「RFC 896 Congestion Control in IP/TCP Internetworks」(Nagle のアルゴリズム):https://www.rfc-editor.org/rfc/rfc896
- util-linux「unshare(1)」:https://man7.org/linux/man-pages/man1/unshare.1.html
- tcpdump「tcpdump(1)」:https://www.tcpdump.org/manpages/tcpdump.1.html
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「オーバーヘッドとは?意味を場面別に|関数・通信・40ms遅延を実測」
株式会社RJC ― SI事業・SES事業・AI駆動開発。RJCは一緒に成長を楽しめる会社です。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。