


- 技術 💻
データ構造の落とし穴8選|LinkedListが遅い理由

データ構造の計算量、O(1)とかO(log n)とか、覚えましたよね。
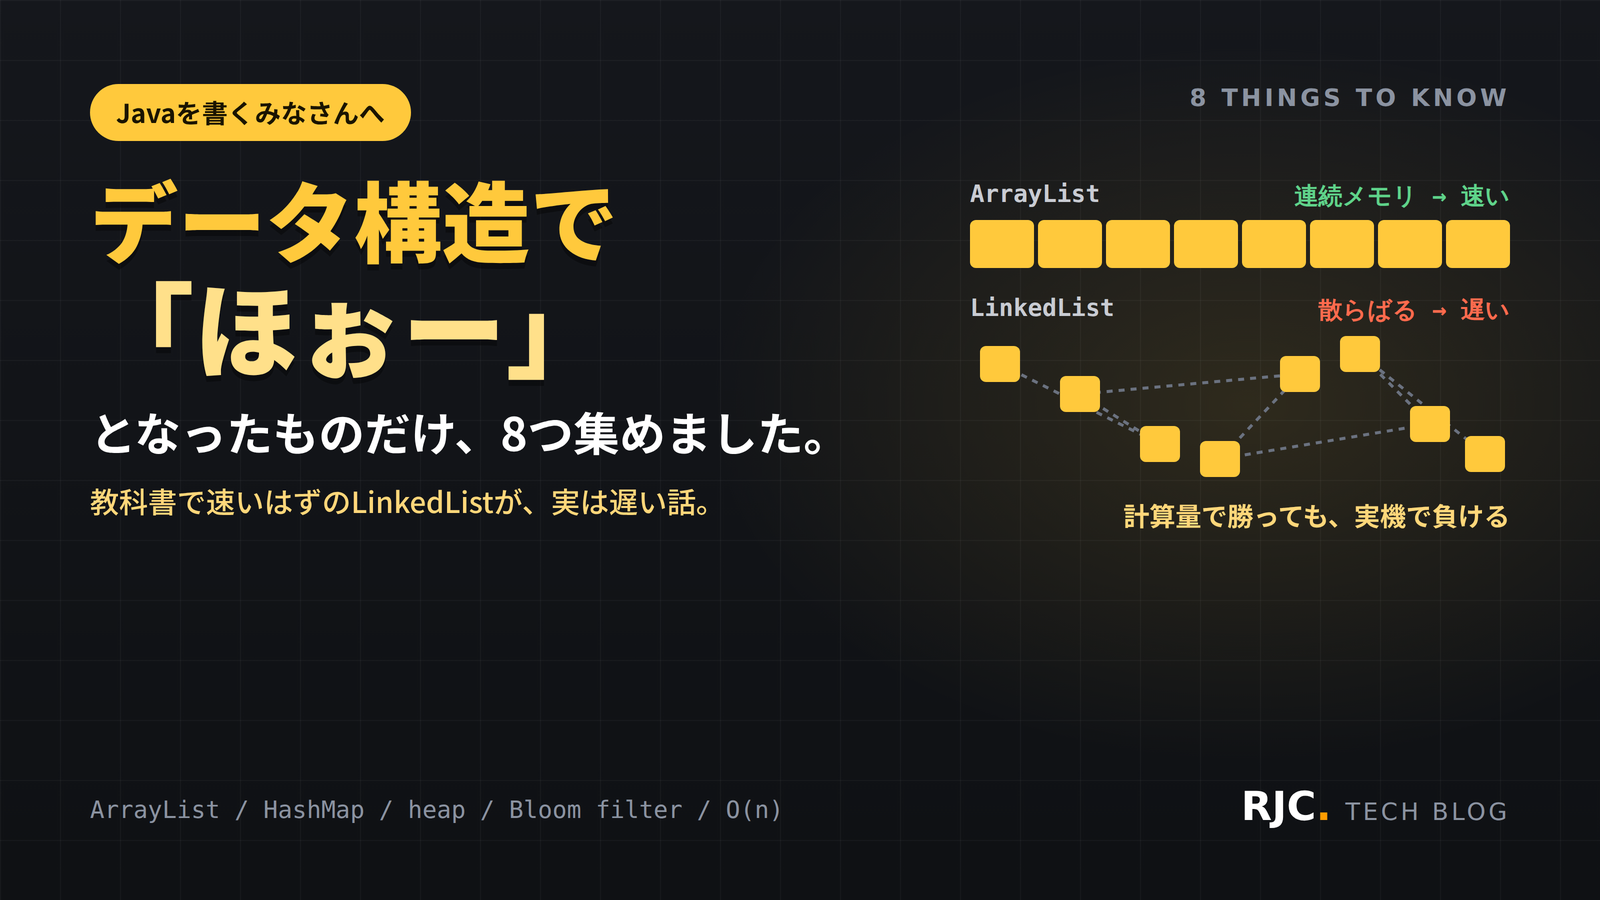
でも実務では、教科書で速いはずの構造が実機で負けたり、O(1)が突然O(n)に化けたりします。理論と実機の間には、段差があるんです。今回は、「教科書で速いはずのLinkedListが、実は遅い」話から、その段差を8つ集めました。1つでも知らなかったら儲けものです。
① ArrayListのaddは、「たまに全コピー」です
list.add(x) の計算量はO(1)——平均は、です。
内部は固定長の配列で、埋まるとより大きい配列を新しく確保して、全要素をコピーします。この瞬間だけO(n)。
ただ、拡張のたびに容量を一定の倍率で増やしている(Javaでは約1.5倍)ので、コピーのコストを全体でならすとO(1)に収まります(ならし計算量)。
だから、要素数が読めているなら最初に容量を指定しておくと、途中の全コピーがゼロになる。「大量addの前に new ArrayList<>(想定数)」は、地味に効く一手なんです。
② HashMapのO(1)は、条件付きです
HashMapの取得はO(1)——ハッシュがうまく分散していれば、です。
複数のキーが同じ場所に集まると(衝突)、そこは連結リストになり、線形探索O(n)に劣化します。
そこでJavaのHashMapは、1箇所の衝突が8個を超えると(表がある程度大きくなっていれば)、その部分を木構造(赤黒木)に変えてO(log n)で耐えるという改良を入れています。
とはいえ大前提は、hashCodeがちゃんと分散すること。自作クラスをキーにするときにhashCodeを雑に実装すると、O(1)のはずが全部詰まる。「O(1)は、良いhashCodeの上に成り立つ約束」なんです。
③ LinkedListは、ほぼ全場面でArrayListに負けます
教科書では「途中の挿入削除はLinkedListが速い(O(1))」。でも実機では、ほとんどの場面でArrayListの方が速いんです。理由は2つ。
- LinkedListの挿入がO(1)なのは「挿入位置を既に持っている」場合だけで、位置まで辿るのにO(n)かかる
- ノードがメモリ上に散らばるので、CPUのキャッシュがまったく効かない
ArrayListは連続メモリなので、多少のコピーを払ってもキャッシュの恩恵が勝つ。
「計算量では勝っているのに、実機では負ける」の代表例。JavaのLinkedListを書いたジョシュア・ブロック本人が「自分が書いたけど、自分では使わない」と言っているほどです。
④ 配列の途中削除には、2つの流派があります
配列から要素を1個消したい。真ん中に穴が空きますよね。
| 要件 | やり方 | 計算量 |
|---|---|---|
| 順序を保つ | 後ろを全部前に詰める | O(n) |
| 順序は要らない | 最後の要素を穴に移動して、末尾を縮める | O(1) |
この「末尾と入れ替え(swap-remove)」は、知らないと絶対に思いつかない一手です。
「並び順はどうでもいいコレクション」なら、削除が劇的に速くなる。順序という要件を1つ捨てるだけで、計算量が変わるんです。
⑤ スタックとキューは、実は「使い方の名前」です
スタック(後入れ先出し)とキュー(先入れ先出し)。別々の構造だと思っていませんか。
実はどちらも、配列やリストの「使い方の制約」にすぎません。両端のどちらから出し入れするかを決めただけ。
そして深いのがここで。「探索の途中を、スタックで管理すれば深さ優先、キューにすれば幅優先」になります。同じ探索コードの、データ構造を差し替えるだけで挙動が変わる。
データ構造は「入れ物」であると同時に、「アルゴリズムの性格を決めるつまみ」でもあるんです。
⑥ 「1位から3位だけ欲しい」に、全ソートは要りません
100万件から上位3件を取りたい。全部ソート(O(n log n))していませんか。
ヒープ(優先度付きキュー)を使えば、3件ぶんの小さなヒープを保ちながら全体を1回舐めるだけ。計算量はO(n log k)で、kが小さければほぼO(n)です。
「常に最大(最小)を効率よく取り出す」のがヒープの仕事。ランキング、締切の近いタスク、経路探索の次候補選び——全体を並べずに、欲しいものだけ取り出す場面で効きます。
全ソートは、実は贅沢な選択だったりするんです。
⑦ 「あるか無いか」だけなら、ほぼゼロのメモリで判定できます
巨大なデータに対して「この要素、含まれてる?」を高速・省メモリで知りたい。
ブルームフィルタという構造があります。要素そのものを保存せず、ビット列だけで管理する。特徴が独特で——「無い」は確実、「ある」は“たぶんある”(ごくまれに誤検知する)。
この割り切りのおかげで、桁違いに小さいメモリで判定できます。「DBを引く前のふるい」として使えば、無駄なアクセスの大半を手前で弾ける。
100%の正確さを少し譲る代わりに、メモリを桁で得する。実務の巨大データで効く発想なんです。
⑧ 正しいデータ構造は、「操作の頻度」から決まります
最後に、選び方の話でまとめます。
データ構造選びは、計算量表の暗記ではありません。「その中で、何を一番多くやるか」で決まります。
| 一番多くやる操作 | 選ぶ構造 |
|---|---|
| 末尾に足して順に読む | 配列(ArrayList) |
| キーで引く | ハッシュマップ |
| 常に最大/最小が欲しい | ヒープ |
| 順序を保った範囲検索 | 木(TreeMap) |
| 含有チェックだけ、省メモリ最優先 | ブルームフィルタ |
「一番頻繁な操作が速い構造」を選び、たまの操作の遅さは許容する。この視点で選べる人が、実機で速いコードを書くんです。
番外編:知っておくと得する小ネタ
文字列の += は、ループ内で罠になります
文字列は多くの言語で不変なので、ループ内の連結は毎回全コピー=O(n²)。専用のビルダー(StringBuilder等)を使うのが定石です。
「だいたい合ってる個数」も数えられます
正確なユニーク数え上げは重いですが、HyperLogLogという構造ならわずかなメモリで“だいたいの個数”を出せます。⑦と同じ「正確さを少し譲って桁で得する」仲間ですね。
配列とリストの違いは、住所です
配列は「連番の部屋」、リストは「次の部屋の地図を持った部屋」。この住所の違いが、③のキャッシュ性能の差を生むんです。
RJCでも、データ構造と向き合っています
大量データを扱う場面では、構造を1つ替えるだけで処理時間が桁で変わることがあります。⑧の「操作の頻度から選ぶ」は、設計レビューで効く視点なんですよね。
こういう仕組みの話を、Techチームで共有しながら開発しています。
よくいただくご質問
Q. まずどれから押さえるべきですか?
A. ⑧の選び方かなと思います。個々の構造の暗記より、「何を一番やるかで選ぶ」という軸を持つ方が、実務では効くんですよね。
Q. 結局、迷ったら何を使えばいいですか?
A. 多くの場面はArrayListとHashMapで戦えます。③のとおり、なんとなくLinkedList、が一番もったいないんです。
Q. 計算量は、どこまで覚えるべきですか?
A. 主要な操作の「速い・遅い」の感覚があれば十分です。正確な記号より、「これはたまに重い(①)」「これは条件付き(②)」を知っている方が実戦的です。
Q. 未経験からでも、分かるようになりますか?
A. なります。データ構造は「本棚・引き出し・行列・トーナメント表」といった日常の道具の比喩で、性格が全部つかめるんです。
計算量は入口で、出口はメモリの形です
今日の8つに共通していたのは、これでした。
計算量の理論は、データ構造選びの入口です。でも実機での勝敗は、メモリの並び(③)、操作の頻度(⑧)、要件の割り切り(④⑦)が決めます。
表を暗記した人ではなく、「この場面で一番やる操作は何か」を問える人が、速い構造を選ぶんですよね。
みなさんが「構造を替えたら速くなった」体験、よかったら教えてください。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




