


- 技術 💻
CPUの気持ち8選|分岐予測・キャッシュライン・高速化


「計算量が同じなら、速さも同じ」——アルゴリズムの教科書では、そうですよね。
でも実機では、同じコードがデータの並び順ひとつで数倍変わります。CPUには、教科書に載っていない「気持ち」があるんです。今回は、その気持ちが分かるものを8つ集めました。1つでも知らなかったら儲けものです。
① ソート済みのデータだと、同じ処理が数倍速くなります
プログラミングQ&Aサイト(Stack Overflow)史上、最も有名な質問のひとつです。
「配列の値が閾値以上なら加算する」だけのループが、配列をソートしておくと数倍速くなる。処理内容は1ミリも変わっていないのに、です。
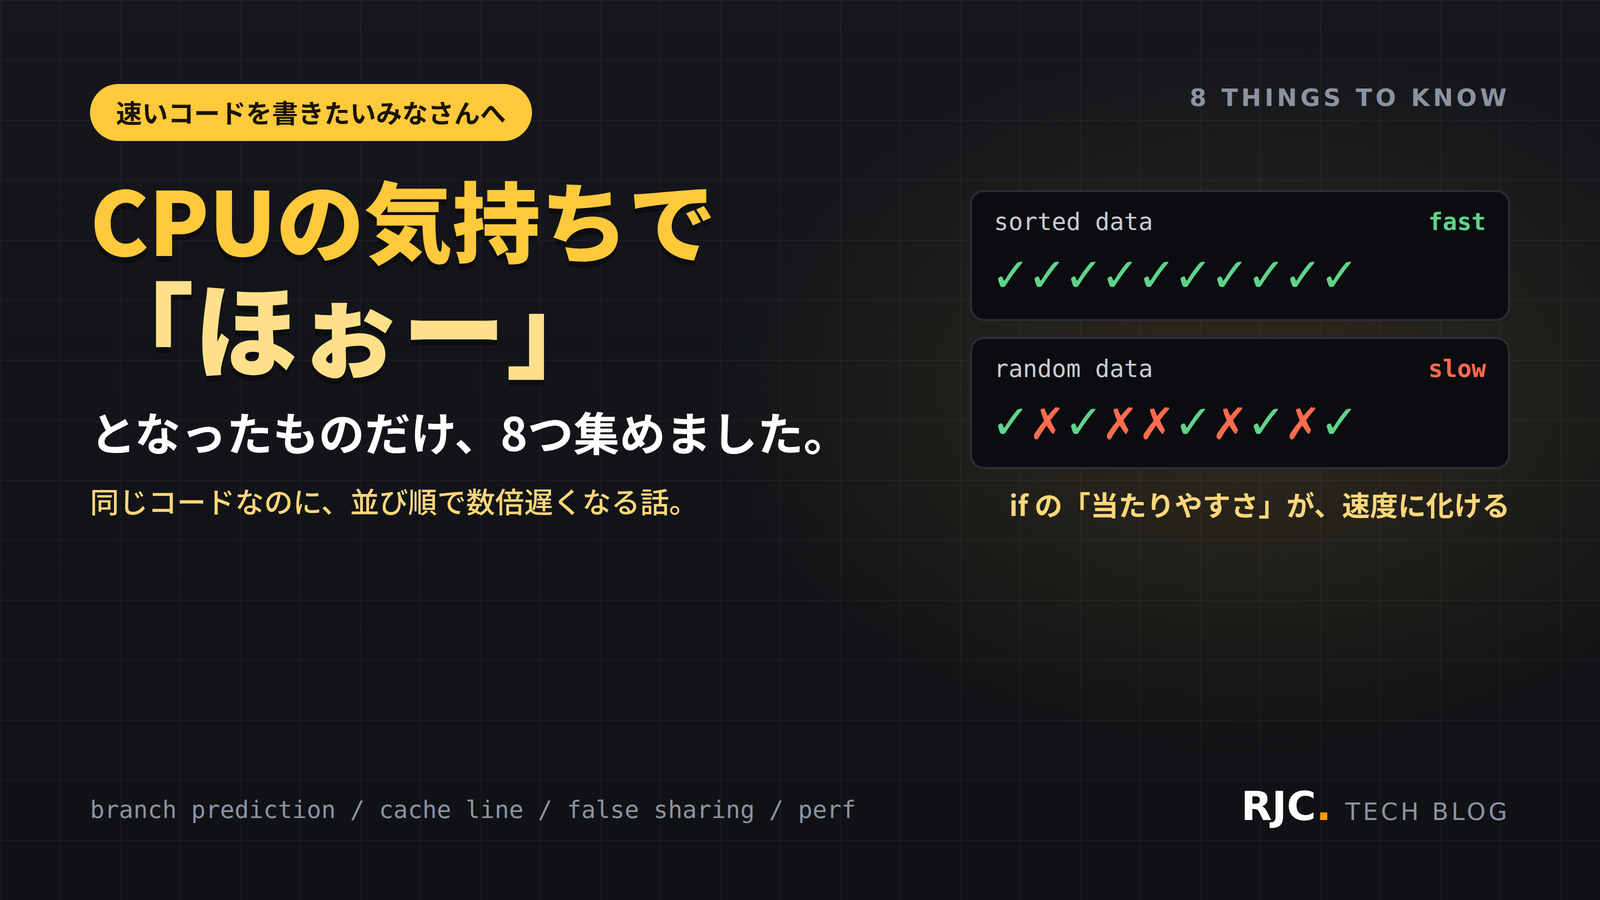
犯人は、CPUの分岐予測。CPUはifの結果を予測して先回りで処理を進めており、予測が当たれば爆速、外れるとやり直しのペナルティを払います。
ソート済みなら「しばらく真、途中から偽」なので予測がほぼ当たる。ランダムだと半分外れる。ifの「当たりやすさ」が、速度に化けるんです。
② CPUから見ると、メモリは「出張」です
速度差を、距離の比喩にするとこうなります。
L1キャッシュが机の引き出しなら、メインメモリは別の建物への出張です。アクセス時間にして、およそ100倍のオーダーで違います。
つまりCPUの仕事の多くは、計算ではなくデータが届くのを待つこと。どんなに速いCPUでも、データが遠くにあれば座って待つだけです。
「速いコード」の正体が「計算が少ないコード」ではなく「待ちが少ないコード」であることが多いのは、この距離のせいなんです。
③ メモリは、「64バイトごと」に運ばれます
CPUはメモリを1バイトずつ取りません。キャッシュラインという単位(一般に64バイト。Apple M1以降などは128バイト)でまとめて運びます。
これが意味するのは、1個読むと、隣の仲間もタダで付いてくるということ。配列を先頭から順に舐める処理が速いのは、次のデータが常に「運ばれ済み」だからです。
逆に、メモリ上を飛び飛びにアクセスすると、64バイト運んで1個しか使わない。同じ回数のアクセスでも、並べ方で燃費が数十倍違うわけです。
データ構造選びは、実は「メモリの並べ方選び」なんです。
④ 二重ループは、回す順番で速度が変わります
③の実践編です。二次元配列の合計を取るループ、内側と外側を入れ替えるだけで数倍の差が出ることがあります。
// 速い:行を順に舐める(メモリ上を連続で進む)
for (int i = 0; i < N; i++)
    for (int j = 0; j < N; j++) sum += a[i][j];

// 遅い:列を先に回す(毎回遠くへ飛ぶ)
for (int j = 0; j < N; j++)
for (int i = 0; i < N; i++) sum += a[i][j];コードの見た目はほぼ同じ、計算量は完全に同じ、速度は数倍違う。ちなみにFortranのように列の順でメモリに並べる言語では、速い順番が逆になります。
「計算量だけでは速度は語れない」ことを、たった数行で体験できる実験です。手元でやると、ちょっと感動しますよ。
⑤ CPUは、命令を「先読みして賭けて」います
①の裏側です。現代のCPUは、命令を1個ずつ真面目に実行していません。
流れ作業(パイプライン)で何十個も同時に処理を進め、分岐が来たら結果を賭けて、当たりを見越して先の命令まで実行しています。投機実行です。
外れたら、先走った分を捨ててやり直し。①のペナルティの正体がこれです。
ちなみにこの「先走り」の痕跡がセキュリティ問題(SpectreやMeltdown)になったのは有名な話。速さのための賭けが、思わぬ副作用を持った例なんです。
⑥ ifを消すと、速くなることがあります
①⑤の応用です。分岐の予測が外れやすい処理では、そもそも分岐を無くすという技があります。
たとえば「大きい方を選ぶ」を、ifではなく算術やmin/max関数で書く。条件の結果を0/1として計算に混ぜ込む。分岐レス(branchless)と呼ばれるスタイルです。
コードは読みにくくなるので、使い所はホットスポット限定。でも「ifは無料ではない」という感覚を持っているだけで、①の現象に説明が付くようになります。
なお、最近のコンパイラはこの変換を自動でしてくれることも多く、①の実験も最適化の設定次第で差が消えることがあります。だからまず計測、です。
⑦ 隣の変数を触っただけで、遅くなることがあります
マルチスレッドでの、渋い罠です。
スレッドAとBが別々の変数を更新している。共有していないから安全で速い——はずが、遅い。
原因は、2つの変数がたまたま同じキャッシュライン(64バイト)に載っていること。CPUはライン単位で所有権を管理するので、別変数でも同じラインなら、コア間でラインの奪い合いが発生します。フォルスシェアリングです。
対策は、頻繁に更新する変数同士を離して配置する(パディング)。「共有していないのに遅い」の犯人は、隣人だったりするんです。
⑧ 結論:速さは、計算量×メモリの形で決まります
今日の話を1枚にまとめます。
教科書の計算量は「命令の回数」の理論です。実機の速度はそこに、分岐の当たりやすさ(①⑤⑥)とメモリの並び(②③④⑦)が掛け算されます。
だから実務の順番はこうです。まず計測して、時間がどこに消えているかを見る。計算を減らすべきか、待ちを減らすべきかは、測れば分かります。
CPUの気持ちを知ることは、勘で最適化するためではなく、計測結果を読める人になるためなんです。
番外編:手元で確かめられる小ネタ
キャッシュラインの大きさを見る
getconf LEVEL1_DCACHE_LINESIZE
# → 64
③の「64」が、実際に自分のマシンから返ってきます(Linuxの場合)。
フリーランチは終わっています
かつては待てばCPUが速くなり、コードも勝手に速くなりました。クロックの伸びが止まった今、性能はコア数と、今日のような「気持ちの理解」から絞り出す時代なんですよね。
perfという聴診器
Linuxのperfコマンドは、分岐予測の外れ回数やキャッシュミスを実測できます。今日の話が「本当にそこで起きているか」を、数字で確かめられますよ。
RJCでも、性能と向き合っています
RJCが携わる決済や交通のシステムには、ピーク時間の処理性能がそのままサービス品質になる場面があります。「なぜ遅いか」を層で説明できる力は、チューニングの土台なんですよね。
こういう仕組みの話を、Techチームで共有しながら開発しています。
よくいただくご質問
Q. まずどれから押さえるべきですか?
A. ②③のメモリの話かなと思います。「速さ=待ちの少なさ」という視点は、日々のデータ構造選びから効くんですよね。
Q. ここまで低レイヤの知識、業務で要りますか?
A. 直接書く機会は少なくても、「計測結果が読める」「ライブラリの速い理由が分かる」という形で効いてきます。⑧のとおり、勘を計測に変えるための知識なんです。
Q. 最適化は、どこまでやるべきですか?
A. 計測でホットスポットが特定できてから、そこだけです。⑥のような読みにくくなる技は、効果が数字で証明できる場所に限定するのが定石ですね。
Q. 未経験からでも、分かるようになりますか?
A. なります。CPUの気持ちは「工場の流れ作業と、倉庫までの距離」の比喩でほぼ説明できるんです。
教科書と実機の間に、ハードウェアがいます
今日の8つに共通していたのは、これでした。
計算量の理論は正しい。でも実機にはその下に、予測して賭けるCPUと、遠くて塊で届くメモリがいます。
この一段下が見えるようになると、「なぜか遅い」が「ここが遠いから遅い」に変わる。性能の話を、感想から観察に変えられるんですよね。
みなさんが体験した「並び順で速度が変わった」話、よかったら教えてください。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




