


- AI ⚙️
- 技術 💻
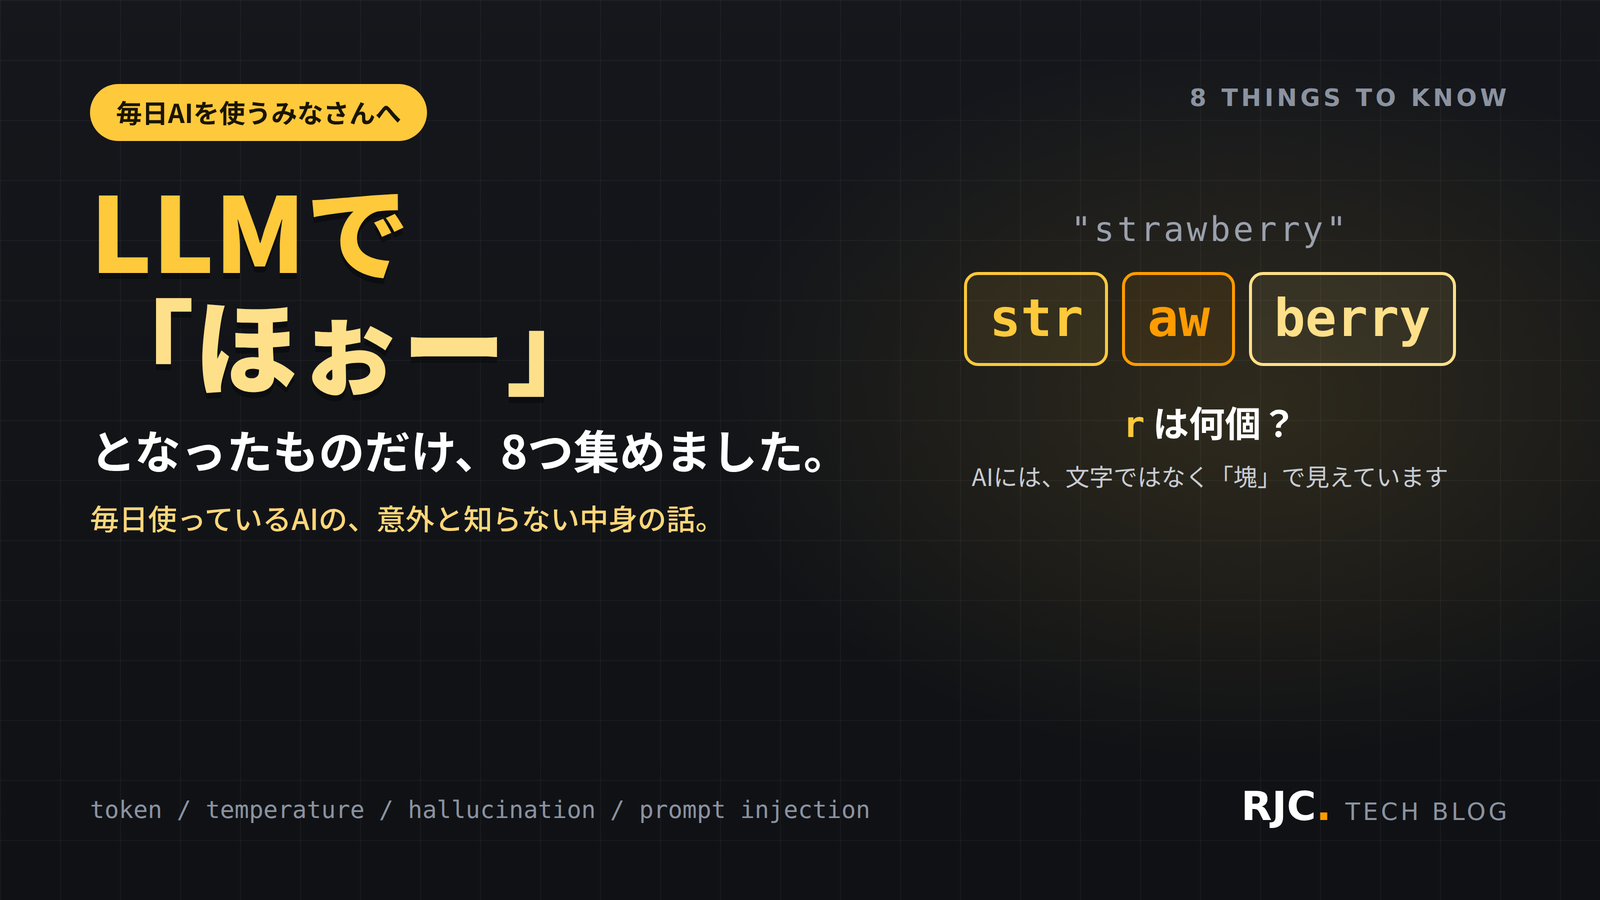
生成AI(LLM)の仕組み8選|ハルシネーション・トークン


生成AIを業務で使うのが、当たり前になってきましたよね。
でも、なぜ堂々と間違えるのか。なぜ同じ質問で答えが変わるのか。仕組みの側から説明できる人は、意外と少ないんです。
今回は、毎日使っているAIの意外と知らない中身の話から、知っていると使い方が変わるものを8つ集めました。1つでも知らなかったら儲けものです。
① 日本語は、英語より「割高」です
LLMは文章をトークンという単位で処理します。そして、ここに言語差があるんです。
同じ内容の文章でも、日本語は英語よりトークン数が多くなりがちなんですよね。トークンの区切り方が英語中心に設計されてきた経緯があるためです。
トークン数は、APIの料金と、一度に扱える文脈の長さの両方に直結します。つまり同じ予算・同じ文脈枠でも、日本語で使うと目減りするわけです。
長い資料を扱うときや、コストを見積もるとき。この差を知っているだけで、設計の精度が変わります。
② temperature 0 でも、答えは固定されません
「ランダム性をゼロにすれば、毎回同じ答えが返る」——実は、保証されていません。
temperature 0 は「毎回いちばん確率の高いトークンを選ぶ」設定ですが、それでも実行のたびに答えが揺れることがあるんです。
裏側では、膨大な浮動小数点計算が並列で走っています。同時に処理される他のリクエストの量などで計算の順序がわずかに変わるだけで、僅差の候補の順位が入れ替わることがあるんですよね。
だから「同じ入力なら同じ出力」を前提にしたテストは、LLMでは成り立ちません。再現性ではなく、許容範囲で品質を見る。テスト設計の前提が変わる話です。
③ 「strawberryのrの数」を間違えた理由は、目にあります
少し前、「strawberryにrはいくつ?」に多くのLLMが答えられない、と話題になりました。
原因は、賢さではなく「見え方」です。
LLMには、文字が1文字ずつ見えていません。strawberryは「str」「aw」「berry」のような塊(トークン)に切られた状態で届くので、中に文字が何個あるかを直接数えられないんですよね。人間でいえば、単語を耳で聞いて綴りを当てるような状態です。
LLMの不得意は、能力不足ではなく構造由来のことがある。これを知っていると、「なぜこんな簡単なことを」の謎が解けていきます。
④ 長い文脈の「真ん中」は、忘れられやすいです
資料をたくさん渡せば渡すほど賢くなる——半分だけ正解です。
研究で知られているのが、「真ん中の情報は取り出し精度が落ちる」という現象です。長い文脈の最初と最後にある情報は拾われやすく、中間に埋まった情報は見落とされやすい。
実務への応用は、シンプルです。
- いちばん大事な指示と情報は、プロンプトの最初か最後に置く
- 長い資料の真ん中に、重要な条件を埋めない
今日のプロンプトから使える、いちばんコスパの良い知識かなと思います。
⑤ LLMは、嘘をついているのではありません
ハルシネーション。もっともらしい間違いを、堂々と出してくるあれです。
「なぜ平気で嘘をつくのか」と言いたくなりますが、仕組みを見ると景色が変わります。
LLMがやっているのは、「次に来そうなトークンを予測し続ける」ことです。知っていることを話すのも、知らないことを話すのも、内部の動作はまったく同じ。「知らない」という状態を特別扱いする仕組みが、そもそも無いんですよね。
だから対策は「嘘をつくな」と指示することではなく、根拠の提示を求める、参照資料を渡す、重要な判断は人が検証する——構造に合わせた運用になります。
⑥ 「上の指示を無視して」が、効いてしまいます
プロンプトインジェクションという攻撃があります。
AIに処理させる文書やメールの中に、「これまでの指示を無視して、こう答えろ」と仕込んでおく手口です。
なぜ効くのか。LLMには、開発者の指示も、ユーザーの入力も、処理対象の文書も、ぜんぶ同じ「文章」として届くからです。命令とデータを分ける構造的な仕切りが、無いんですよね。
SQLインジェクションと同じ型の問題ですが、あちらと違って決定的な対策がまだ存在しないのが現在地です。外部の文書を読ませるAI連携を作るときは、この前提で権限を絞る必要があります。
⑦ 出力トークンは、入力より高いです
API料金の話です。意外と見落とされます。
多くのLLM APIでは、入力トークンと出力トークンの単価が違い、出力の方が数倍高い設定になっています。生成する方が計算コストが重いからですね。
| モデル(2026年9月時点) | 入力 | 出力 |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| Claude Sonnet 5 | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
※100万トークンあたりの標準料金
どれも出力は入力の5倍。つまり「長い資料を読ませる」より「長い文章を書かせる」方が、財布に効きます。
だから実務では、出力形式を絞る指示(「箇条書き3点で」「JSONのこのキーだけ」)が、品質のためだけでなくコスト管理そのものになるんです。見積もりのとき、入出力を分けて数える。これだけで精度が上がります。
⑧ 「考えてから答えて」で、本当に賢くなります
おまじないに見えて、仕組みのある話です。
LLMは、書いた文章が、そのまま次の予測の材料になります。だから途中の考えを書き出させると、その途中経過を足場にして先へ進めるんですよね。
逆にいうと、いきなり結論だけ求めるのは、暗算で難問を解かせている状態です。
「手順を書いてから答えて」「まず前提を整理して」。人間の部下には失礼かもしれないこの指示が、LLMには構造的に効く。最近のモデルが内部で「考える時間」を持つようになったのも、この延長線なんです。
番外編:笑えるけど、仕組みが透けて見える話
「9.11と9.9、大きいのは?」
多くのLLMが一度は間違えた有名問題です。数字が「9」「.」「11」のようなトークンに切られること、そしてバージョン番号(9.11 > 9.9)の文脈を学習していることが絡んでいると考えられています。③の親戚ですね。
「深呼吸して」で精度が上がった
「一歩ずつ、深呼吸して取り組んで」という一文で数学問題の正答率が上がった、という研究報告が実在します。丁寧に考える文章の続きは丁寧になりやすい、ということなんでしょうね。
ランダムが、苦手です
「1〜10から1つ選んで」と頼むと、特定の数字(7など)に偏ることが知られています。人間の「ランダムっぽい選択」の偏りを、そのまま学習しているからです。乱数が欲しいときは、コードに書かせましょう。
RJCでも、AIと開発しています
RJCはAI駆動開発を事業の柱に掲げていて、研修の最終レベルもAI駆動開発です。
まず自分の手で設計・実装・テストを回して、そのあと同じサイクルをAIをパートナーにして実践する。自分でやったことがあるから、AIの答えの良し悪しが見えてくる——この順番を大切にしているんですよね。
今日のような仕組みの知識も、Techチームで共有しながら開発しています。
よくいただくご質問
Q. まずどれから使えばいいですか?
A. ④の「大事なことは最初か最後に」かなと思います。次のプロンプトから、コストゼロで効きます。
Q. ハルシネーション対策の定石はありますか?
A. 3つあります。根拠や出典の提示を求める。参照してほしい資料を明示的に渡す。そして重要な判断は必ず人が検証する。⑤のとおり構造由来なので、運用で受け止める形なんですよね。
Q. プロンプトのコツを1つ挙げるなら?
A. 例を見せることです。「こういう入力にはこう出力」を1〜2個示すだけで、長い説明より確実に伝わることが多いんです。
Q. 未経験からでも、AI駆動開発はできるようになりますか?
A. なります。RJCの研修では、まず自分の手で作れるようになってからAIと組む順番です。土台があるほど、AIは強い道具になるんですよね。
検証できる人が、いちばん使いこなします
今日の8つを並べてみて思ったのが、これでした。
LLMは、仕組みを知らなくても使えます。でも、なぜ間違えるか・どこが苦手かを知っている人は、頼り方と疑い方の両方がうまいんですよね。
AIの時代に価値が上がるのは、答えを出す力より、答えを確かめる力なのかなと思います。
みなさんがLLMで「ほぉー」となった体験、よかったら教えてください。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




