


- 技術 💻
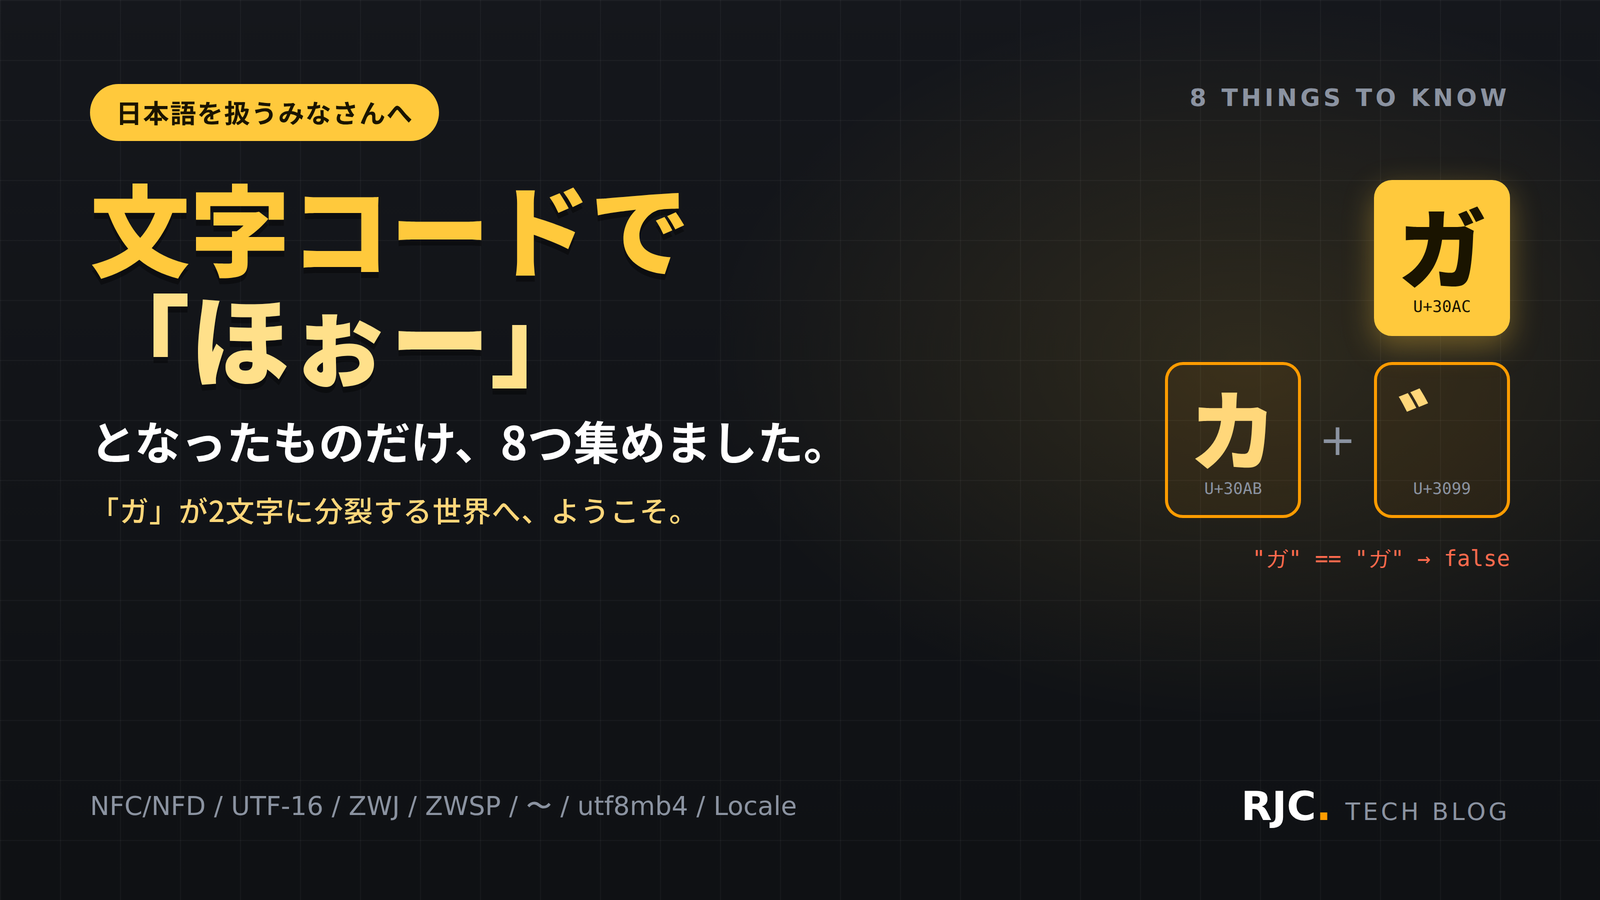
文字化けの原因8選|濁点分離・utf8mb4・絵文字の文字数


文字コードって、化けたときにしか意識しないんですよね。でも、氏名の検索がヒットしない、絵文字でDBが壊れる、Macから来たファイル名だけおかしい。日本語のシステムを作るかぎり、一生付き合う相手です。
今回は、知っていると原因調査が一瞬で終わるものを8つ集めました。「ガ」が2文字に分裂する世界へ、ようこそ。1つでも知らなかったら儲けものです。
① 「ガ」が、2文字に分裂する世界があります
Macで作ったzipをWindowsで開いたら、「ガイド」が「カ゛イト゛」みたいになった——見たことありませんか。
実はUnicodeには、同じ「ガ」を表す方法が2つあります。1つは「ガ」という合成済みの1文字。もう1つは「カ」+「濁点」という2文字の組み合わせです。見た目はまったく同じなのに、中身が違うんですよね。Macのファイル名は伝統的に分解形で扱われてきたので、Windows側に渡ると分裂して見えることがあります。
そして怖いのがここで。見た目が同じでも、プログラムにとっては別の文字列です。比較すればfalse、検索すればヒットしない。「あるはずのファイルが見つからない」の古典的な犯人なんです。
② 絵文字1個の長さが、「2」になります
JavaScriptで試してみてください。
"🍣".length // → 2寿司1貫で、2です。JavaScriptの文字列は内部がUTF-16で、基本領域に収まらない文字は2つの単位(サロゲートペア)で表現されるからなんですよね。
これが実害になるのが、文字数制限と切り詰めです。「10文字まで」のつもりでsubstringすると、絵文字のド真ん中で切断して、壊れた文字が生まれます。
ちなみに「𠮟る」の「𠮟」(口へんの叱)もこの仲間です。絵文字を使っていなくても、常用漢字で踏むことがあるんです。
③ 家族の絵文字は、中身が7個です
👨👩👧👦 という家族の絵文字、1文字に見えますよね。中身は、「男性」「女性」「女の子」「男の子」の4文字を、見えない接着剤(ゼロ幅接合子)3個で繋いだ、計7個の文字です。
だから文字単位で分割する処理に通すと、家族が離散します。逆順にする、1文字ずつ処理する、途中で切る——ぜんぶ危険です。
「1文字に見えるまとまり」は書記素クラスタと呼ばれていて、正しく扱うには専用の分割処理が要ります。「1文字ずつ処理すれば安全」という直感が、Unicodeでは通用しないんです。
④ 見えない文字が、実在します
幅がゼロのスペース(ゼロ幅スペース)という文字があります。見えない。選択しづらい。でも、存在する。
Webページからコードをコピペしたときに紛れ込んで、「見た目は完全に正しいのにコンパイルが通らない」「同じに見える文字列が一致しない」という、最高にイライラする事象を起こします。
エディタの「不可視文字を表示」をONにすると、正体が見えます。目で見て同じ=同じ文字列、ではない。文字コードの世界の大原則です。
⑤ 「〜」には、そっくりさんがいます
日本語界の古傷、波ダッシュ問題です。「〜」に見える文字は、Unicodeに波ダッシュと全角チルダの2種類があります。見た目はほぼ同じ。でも別の文字です。
歴史的な変換表の違いで、WindowsとMacでどちらの「〜」になるかが分かれてきたんですよね。その結果、「10時〜17時」で検索してもヒットしない、環境をまたぐと「?」に化ける、という事故が延々と起きてきました。
対策は、入力を保存する前に正規化して片方に寄せること。「〜」を信用しないのが、日本語処理の作法なんです。
⑥ MySQLの「utf8」には、絵文字が入りません
これは知らないと本番で踏みます。MySQLの utf8 という文字コード指定は、実は1文字3バイトまでの不完全なUTF-8です。
UTF-8で日本語のかなや漢字は3バイト。ここまでは入ります。でも絵文字は4バイト。つまりユーザーが名前欄に絵文字を入れた瞬間、エラーか文字欠けが起きるんですよね。
完全なUTF-8は、utf8mb4 という別名の方です。いまのMySQLではこちらが標準になりましたが、古い設計のDBには3バイト版がまだ残っています。「絵文字を保存したら壊れた」の原因は、ほぼこれです。
⑦ 大文字変換の結果は、言語で変わります
toUpperCase() の結果が世界共通だと思っていませんか。
有名なのがトルコ語です。トルコ語には「点のない i」と「点のある i」が別の文字として存在するので、トルコ語ロケールで 'i' を大文字にすると、'I' ではなく 'İ' になります。
この仕様で実際に起きるのが、ロケール依存の変換事故です。英語のつもりで書いた "TITLE".toLowerCase() が、トルコ語環境では "tıtle" になって、文字列比較が突然falseになる。
だからJavaなどでは、プログラム内部の変換にロケールを明示する(Locale.ROOT など)のが定石になっています。文字の変換は、数学ではなく文化なんです。
⑧ 「文字数」の数え方は、3種類あります
ここまでの話を、1つにまとめるとこうなります。同じ文字列に、長さが3つあるんです。
- バイト数:保存サイズの世界。日本語3バイト、絵文字4バイト
- コードポイント数:Unicodeの文字の個数。家族絵文字は7
- 書記素クラスタ数:人間が見た「1文字」のまとまり。家族絵文字は1
「10文字まで」という仕様書の1行が、実装では3通りに解釈できてしまう。DBの制限・APIの制限・画面の表示が、それぞれ別の数え方をしていることも珍しくありません。
文字数の仕様を決めるときは、「どの数え方か」まで言葉にする。これだけで事故が1つ減ります。
番外編:手元で確かめられる小ネタ
家族を数えてみる
python3 -c 'print(len("👨👩👧👦"))'
# → 7Pythonのlenはコードポイント数なので、7が返ります。
BOMという見えない先頭文字
UTF-8のファイル先頭に付くことがある目印(BOM)も、見えない文字の仲間です。厄介者扱いされがちですが、ExcelでCSVを文字化けさせずに開くには、逆にBOMが必要という、憎めない一面もあります。
「髙」と「﨑」は要注意
はしごの髙、立つ崎。氏名でよく出会うこれらは、環境によって表示できたりできなかったりする筆頭です。氏名を扱うシステムでは、対応範囲を最初に決めておくのが定石です。
RJCでも、文字と戦っています
RJCが携わる保険、金融、人材のシステムは、氏名と住所の正確な扱いが仕様の中心にある世界です。外字、旧字体、全角半角の揺れ。今日の話は雑学ではなく、この領域ではそのまま設計項目なんですよね。
だからこういう知識を、Techチームで共有しながら開発しています。文字を正しく扱えることが、そのまま信頼になる仕事なんです。
よくいただくご質問
Q. まずどれから押さえるべきですか?
A. ⑥のutf8mb4かなと思います。DB設計の最初の1行で決まる話なのに、壊れるのはリリース後なんですよね。
Q. 対策の定石はありますか?
A. 3つあります。入力は保存前に正規化して揺れを片方に寄せる。DBは完全なUTF-8(utf8mb4)にする。文字数の仕様は「どの数え方か」まで明記する。この3つでかなり守れます。
Q. 絵文字対応って、本当に必要ですか?
A. ユーザー入力を受けるなら必須だと思います。こちらが想定しなくても、名前欄や備考欄には普通に入ってくるんですよね。
Q. 未経験からでも、ここまで分かるようになりますか?
A. なります。len()やlengthで色々な文字を測ってみるだけで、今日の話は全部体験できます。手を動かした人から分かる領域です。
「1文字」を疑えるようになると、強いです
今日の8つに共通しているのは、「1文字」という言葉の曖昧さでした。見た目の1文字、コード上の1文字、保存上の1文字。ぜんぶ違うことがある。
だから文字の不具合に出会ったとき、「そもそもどの意味の1文字だっけ?」と問えるだけで、調査の入口が変わるんですよね。
みなさんが文字コードで踏んだ事故、よかったら教えてください。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




