


- データベース
- 技術 💻
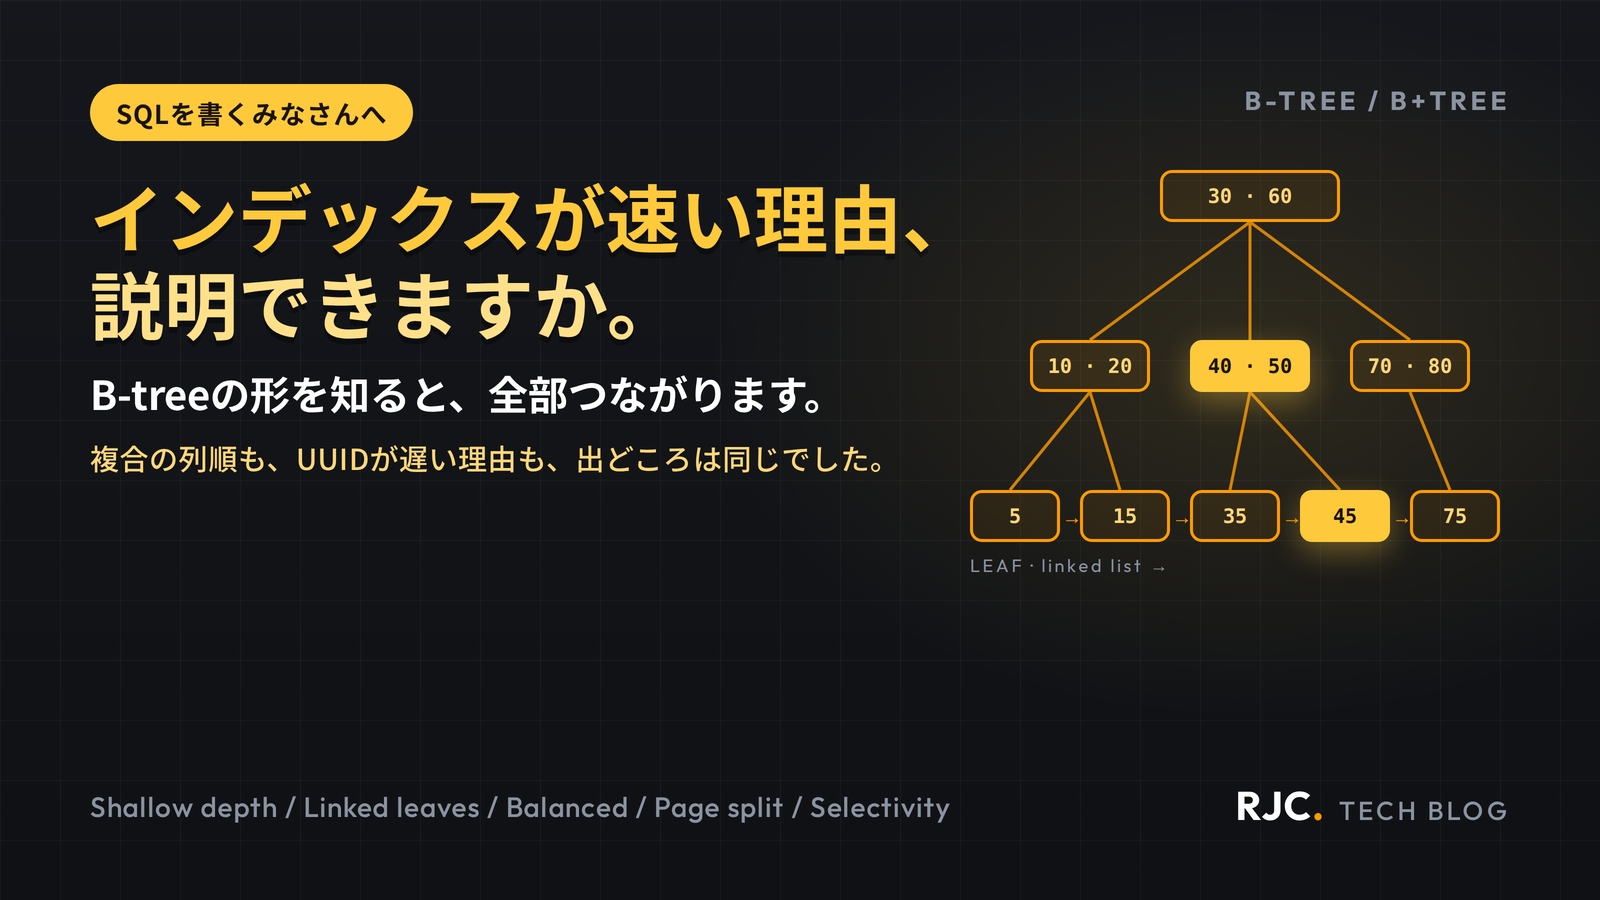
インデックスはなぜ速い?B-tree(B+tree)の仕組み


インデックスを貼ると速くなる。これは誰でも知っていますよね。でもなぜ速いのかを説明しようとすると、意外と難しい。
今回はB-treeという構造を見ていきます。この形ひとつで、インデックスまわりの現象がほぼ全部説明できるんですよね。複合インデックスの列順も、UUIDが遅い理由も、出どころは同じでした。
形は、組織図に近いです
B-treeは、木の構造をしています。一番上に根があって、そこから枝分かれして、一番下に葉が並ぶ。探すときは、根から順に「この値はこっちの枝だな」と降りていくだけです。全部を見なくても、目的の葉にたどり着けるんですよね。
ここまでは、二分探索と同じ発想です。
決定的なのは、枝の多さです
二分探索木と違うのが、1つのノードが2択ではなく、数百の枝を持てることなんです。なぜかというと、DBはデータをページという固定サイズの塊で読むから。1回の読み取りでページ全部が手に入るなら、そこにできるだけ多くの目印を詰め込んだ方が得ですよね。
結果、階層がとても浅くなります。100万行でも、3〜4階層で届きます。そして1000万行に増えても、せいぜい1段増える程度なんです。
データが10倍になっても、探す手間はほとんど変わらない。ここがインデックスの本質かなと思います。
葉は、順番に並んで繋がっています
もうひとつの特徴です。一番下の葉は、値の順に並んでいて、隣同士がリンクで繋がっています。だから範囲検索が速いんですよね。「8月1日から8月31日まで」なら、最初の葉を見つけて、あとは横に読んでいくだけ。木を何度も上り下りする必要がありません。
ここから、いくつかの現象が説明できます。
ORDER BYがインデックスで解決できるのは、すでに並んでいるから。ソート処理そのものが要らなくなるんです。
複合インデックスの列順が効くのも、並び順が列の順番で決まるから。(A, B) なら、まずAで並んで、Aが同じ中でBで並ぶ。電話帳が姓で並んで、同じ姓の中で名前順になっているのと同じですね。
そして範囲条件の後ろの列がソートに使えない理由も、ここにあります。Aを範囲で絞ると、その中のBの並びはバラバラになってしまうので。
「バランス」しているのが、名前の由来です
Bはbalanced(均衡)から来ている、というのが有力な説です。何が均衡しているかというと、どの葉までの距離も同じなんですよね。データを追加しても削除しても、木が自動的に形を整えます。片側だけ深くなることがない。だからどの行を探しても、同じ回数で届くんです。「運が悪いと遅い」が起きない。
ちなみにBの由来には諸説あって、開発者のBayerから取ったという説もあります。本人が明言していないので、決着していないんですよね。こういう話、けっこう好きです。
実は、正確にはB+treeです
マニアックな話をひとつ。多くのDBが「B-treeインデックス」と呼んでいるものは、厳密にはB+treeという派生形なんです。違いは2つ。
| B-tree | B+tree | |
|---|---|---|
| データの場所 | 枝にもデータを持つ | 葉にしか持たない。枝は道案内に徹する |
| 葉の連結 | なし | 葉同士がリンクで繋がっている |
この2つのおかげで、枝に目印だけを詰め込めるので枝の数がさらに増え、範囲検索では横に読むだけで済むようになります。さっき書いた「浅い階層」と「速い範囲検索」は、実はこの派生形の恩恵なんですよね。
ページ分割も、この形から起きます
葉は、ページという固定サイズの箱に入っています。満杯のページに新しい値が入ると、箱を2つに割って半分ずつ入れ直す。これがページ分割です。ここから、また別の現象が説明できます。
ランダムなUUIDを主キーにすると遅くなるのは、挿入位置がバラバラで分割が多発するから。時刻順に増える値なら、常に末尾に追加されるので分割が起きにくいんですよね。UUIDを使うなら時刻順に並ぶ形式を、と言われるのはこのためです。
断片化も、この分割の積み重ねで起きます。論理的な順番と物理的な配置がズレていく現象ですね。
一意性の話も、ここに繋がります
根から葉まで降りて、1件に絞れるなら理想的です。テーブルを1回見に行けば終わりますよね。でも50万件がヒットするとどうなるか。1件ずつテーブルを見に行くことになります。それなら最初から全部を順に読んだ方が速い。
「インデックスを貼ったのに使われない」の正体が、これなんです。選択率が高すぎると、フルスキャンの方が有利になる。つまりB-treeは、一意性が高いほど効果的なんですよね。
ビットマップは、まったく別の仕組みです
ここを混同すると、話が正反対になります。ビットマップインデックスは、この木構造を使いません。値ごとにビット列を持って、複数条件をビット演算で処理する仕組みです。だから向いている条件も逆で、値の種類が少ないほど効率的になります。
「一意性が高いと無意味」という話を聞くことがありますが、それはビットマップの話なんですよね。B-treeの話と混ざると、まったく噛み合わなくなります。
形を知ると、判断できるようになります
整理すると、こうなります。
| 形の特徴 | そこから出てくる現象 |
|---|---|
| 階層が浅い | データ量が増えても速度が落ちにくい |
| 葉が順番に並んでいる | 範囲検索とORDER BYが速い、複合の列順が効く |
| バランスしている | どの行でも同じ速さ |
| ページ分割が起きる | ランダムな主キーは遅く、断片化も進む |
| 1件に絞れるほど有利 | 選択率が低いほど効く |
覚えることが5つに見えますが、ぜんぶ同じ形から出ているんですよね。だから丸暗記しなくても、木の形を思い浮かべれば導けます。
よくいただくご質問
Q. 階層が浅いと、なぜ速いんですか?
A. 1階層降りるごとに、ディスクからページを1回読むことになるからです。3階層なら3回。ここが速度を決めているんですよね。
Q. B-treeとB+tree、意識して使い分けるものですか?
A. 実務では意識しなくて大丈夫です。ほとんどのDBがB+treeを採用しているので、「B-treeインデックス」と言えばこちらを指しています。
Q. 木の形って、どうやったら見られますか?
A. 直接見るのは難しいですが、EXPLAINで何回読んだかは分かります。そこから逆算して想像するのが現実的かなと思います。
Q. 未経験からでも、ここまで理解できますか?
A. できます。形さえ掴めば、あとは全部そこから説明がつくんですよね。むしろ暗記が減ります。
仕組みを知ると、暗記が減ります
インデックスまわりって、覚えることが多く見えるんですよね。複合の列順、選択率、断片化、主キーの選び方。バラバラのルールとして覚えようとすると、けっこう大変です。
でもぜんぶB-treeの形から出ていると分かると、思い出す必要がなくなります。導けるようになるので。こういう「元をたどると1つ」という構造、技術の世界にはよくありますよね。見つけると、一気に軽くなります。
みなさんの「これも仕組みを知ったら一気に分かった」というもの、あればぜひ教えてください。
関連記事:DBのインデックスで「ほぉー」となったものだけ、8つ集めました(公開後にリンクを差し込んでください)
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




