


- データベース
- 技術 💻
DBパーティショニングで遅くなる理由|効く条件と落とし穴5つ


テーブルが大きくなってきたから、パーティショニングで分割する。よくある判断ですよね。でも分けたのに速くならない、むしろ遅くなった、という話も聞きます。
今回は、何が速くなっていて、どこで外れるのかを整理しました。効く条件と、外したときの落とし穴です。異論・追加も大歓迎です。
そもそも、何が速くなっているのか
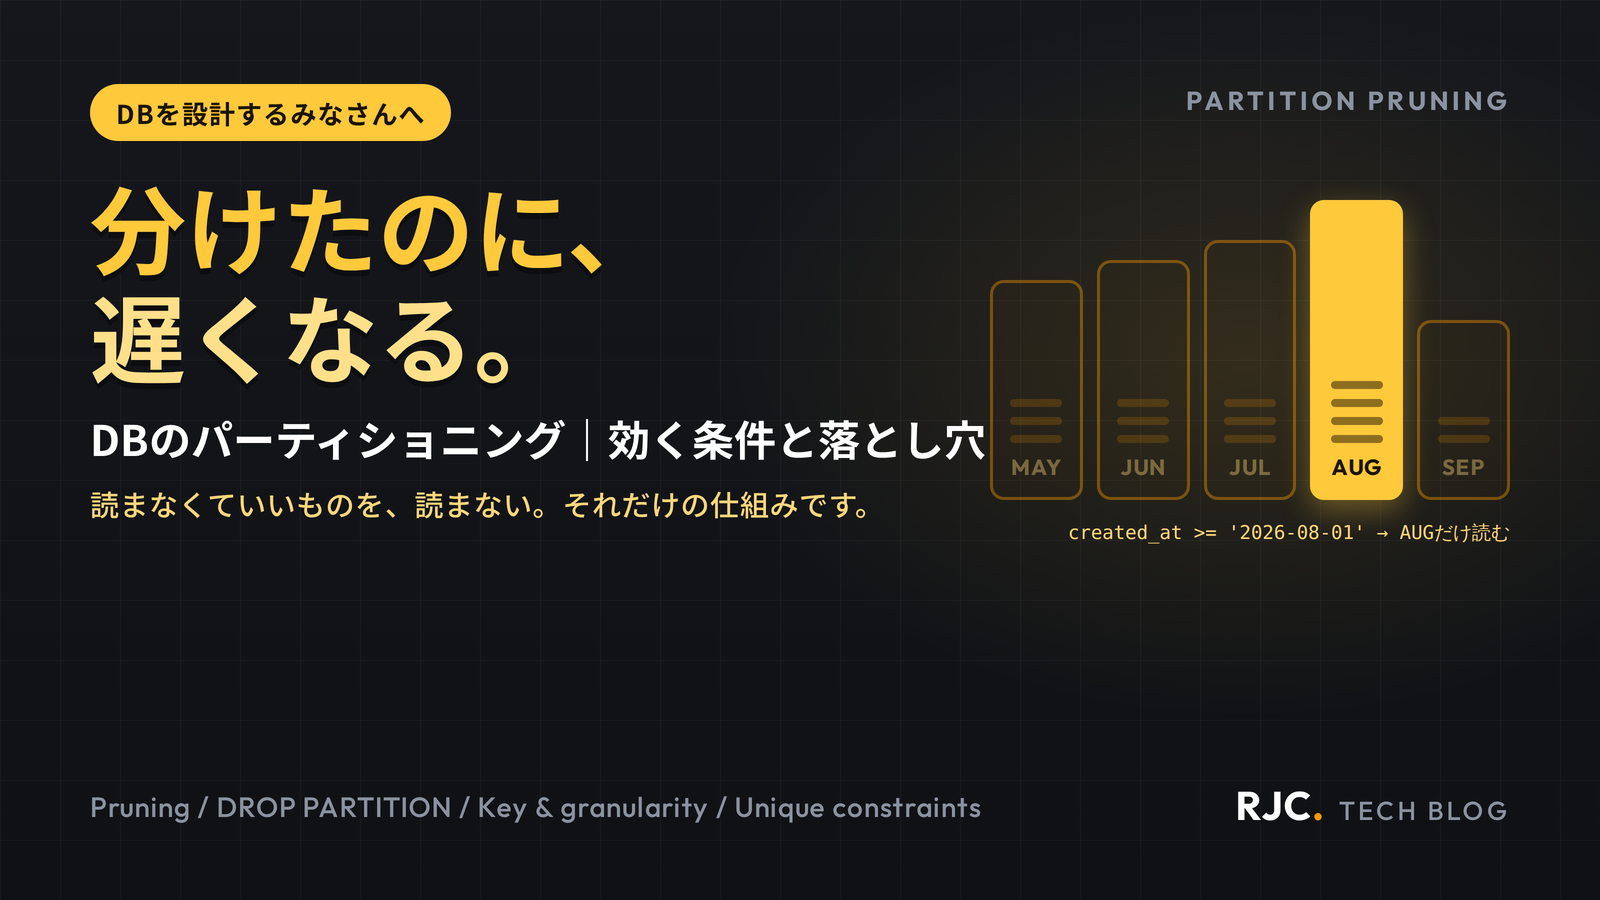
パーティショニングの効果を一言でいうと、読まなくていいものを読まないことです。1億行のテーブルを月ごとに分けたとします。
SELECT * FROM logs WHERE created_at >= '2026-08-01';このとき、8月のパーティションだけを見に行けばいい。他の月は開きもしないんですよね。これをパーティションプルーニング(枝刈り)といいます。
インデックスが「どこにあるかを速く探す」仕組みなのに対して、パーティショニングは「そもそも探す範囲を狭める」仕組みなんです。役割が違うんですよね。
削除が、桁違いに速くなります
これも大きな効果です。「1年より古いログを削除する」という処理。
DELETE FROM logs WHERE created_at < '2025-08-01';これ、行数が多いと本当に重いんですよね。1行ずつ削除の記録が残り、トランザクションログが膨らみ、他の処理にも影響が出ます。パーティションを分けていれば、こうなります。
ALTER TABLE logs DROP PARTITION p202507;ほぼ一瞬で終わります。ファイルを切り離すだけなので、ログもほとんど出ません。古いデータを消し続ける運用があるなら、この一点だけでも導入する価値があるかなと思います。
インデックスも、小さくなります
見落とされがちですが、地味に効きます。パーティションごとに独立したインデックスを持つ形にすると、1つあたりのインデックスが小さくなるんですよね。B-treeは階層構造なので、サイズが小さいほど階層が浅くなります。つまり、たどる回数が減る。
さらに、メンテナンスもパーティション単位でできます。統計情報の更新も、再構築も、全体に対してやる必要がなくなるんですよね。
① WHERE句にキーがないと、全部読みます
ここから落とし穴です。これが最大の罠かなと思います。日付で分割したテーブルに、こう投げたとします。
SELECT * FROM logs WHERE user_id = 42;プルーニングが効きません。どのパーティションに入っているか分からないので、全部を順に見に行くことになります。分割していないときより遅くなることもあるんですよね。管理する対象が増えているので。
つまりパーティションキーは、必ずWHERE句に入る列を選ぶ必要があります。「データ量が多いから日付で分ける」ではなく、「検索が必ず日付で絞られるから日付で分ける」。この順番なんですよね。
② 数が多すぎると、逆効果です
細かく分けるほど効きそうな気がしますが、そうでもないんです。DBはクエリを実行する前に、どのパーティションを読むかを判断する処理を行います。数が多いほど、この判断に時間がかかるんですよね。
日次で3年分なら1000個以上になります。1回のクエリで数個しか読まないのに、毎回1000個を検討することになる。粒度は、消す単位と検索の単位に合わせる。月次で足りるなら月次で十分かなと思います。
③ 一意制約に、制限がかかります
これは設計段階で効いてくる話です。パーティションごとに独立したインデックスを持つ場合、そのインデックスは自分のパーティションの中しか知りません。だから「テーブル全体で一意」を保証できないんですよね。
PostgreSQLでは、主キーやユニーク制約にパーティションキーを含める必要があります。
-- created_at で分割しているなら
PRIMARY KEY (id, created_at)
「idだけで一意」にしたくても、できない。ここを知らずに設計を進めると、後から作り直しになります。
④ 受け皿のパーティションは、扱いに注意です
PostgreSQLには、どの範囲にも当てはまらない行を受け止めるDEFAULTパーティションがあります。便利なんですが、ここにデータが入っている状態で新しいパーティションを追加すると、DEFAULTの全件スキャンとロックが発生します。追加する範囲の行がDEFAULTに紛れ込んでいないかを確認するためですね。
運用としては、DEFAULTは常に空にしておくのが安全かなと思います。入っていたら、それは設計漏れのサインです。
⑤ キーの更新は、行の移動になります
パーティションキーの値を更新すると、その行は別のパーティションへ移動します。内部的には、元の場所から削除して、新しい場所に挿入する動きですね。つまり通常の更新より重い。しかも設定によっては、そもそも許可されていないこともあります。
パーティションキーには、あとから変わらない値を選ぶ。作成日時が定番なのは、これも理由です。
設計するときの順番
整理すると、こうなるかなと思います。
- どんな検索が来るかを先に決める。必ずWHERE句に入る列は何か。ここがキーの候補です
- 消す単位を確認する。月単位で消すなら月次分割。ここが粒度の目安になります
- 一意制約を確認する。キーを含めた形で成立するか。ここで詰まるなら、設計を見直す段階ですね
- 自動作成の運用を決める。未来のパーティションを、誰がいつ作るのか。手動運用だと、忘れた瞬間に書き込みエラーになります。DBによっては自動で作る仕組みや拡張があるので、そこを含めて決めておくと安心です
DBによって、できることが違います
主要なところだけ書いておきますね。
PostgreSQLは宣言的パーティショニングを備えていて、パーティションの切り離しをオンラインで行える仕組みもあります。MySQLはレンジ・リスト・ハッシュに対応していますが、外部キー制約が使えないという制限があります。Oracleには、範囲を超えたデータが来たときに自動でパーティションを作る仕組みがあります。運用の手間がかなり減りますね。
同じ「パーティショニング」でも中身が違うので、移行時は必ず確認が必要な部分です。
既存テーブルの移行は、別の難しさがあります
最後にひとつだけ。これから作るテーブルなら簡単なんですが、すでに動いているテーブルを分割するのは大仕事です。新しくパーティション化したテーブルを作り、データを移し、切り替える。その間もサービスは動いている。
だから、大きくなる前に分けておく方が圧倒的に楽なんですよね。「まだ小さいから後で」と思っていると、分けたくなった頃には分けるのが難しくなっている。ここは経験則として持っておくといいかなと思います。
よくいただくご質問
Q. インデックスとパーティション、どちらを先に検討しますか?
A. まずインデックスかなと思います。パーティショニングは構造を変える判断なので、影響範囲が大きいんですよね。
Q. どのくらいのサイズから検討すべきですか?
A. サイズより運用が判断材料かなと。「古いデータを定期的に消す」という要件があるなら、小さいうちから入れる価値があります。
Q. 分割したら、必ず速くなりますか?
A. なりません。①で書いたとおり、キーがWHERE句に入らない検索は逆に遅くなります。何を速くしたいかが先ですね。
Q. 未経験からでも、こういう設計ができるようになりますか?
A. なります。まずEXPLAINで実行計画を読めるようになるのが近道かなと思います。効いているかどうかが、目で見えるようになるので。
分けること自体は、目的ではありません
今日いちばんお伝えしたかったのは、ここかもしれません。パーティショニングは「大きいから分ける」ではなく、「この検索を速くしたい」「この削除を軽くしたい」という目的から決まるものなんですよね。目的がないまま分けると、管理する対象が増えるだけになります。
何を読まなくて済むようにしたいのか。そこがはっきりしていれば、キーも粒度も自然に決まってくるかなと思います。
みなさんの「これで痛い目を見た」「うちはこう運用している」も、ぜひ教えてください。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




