


- AI ⚙️
- 技術 💻
Gemini APIならでは8選【2026年9月】Mapsグラウンディング・Managed Agents


Geminiって、他のモデルにない機能がけっこうあるんですよね。チャットとして使っているだけだと、たぶん気づかない部分です。
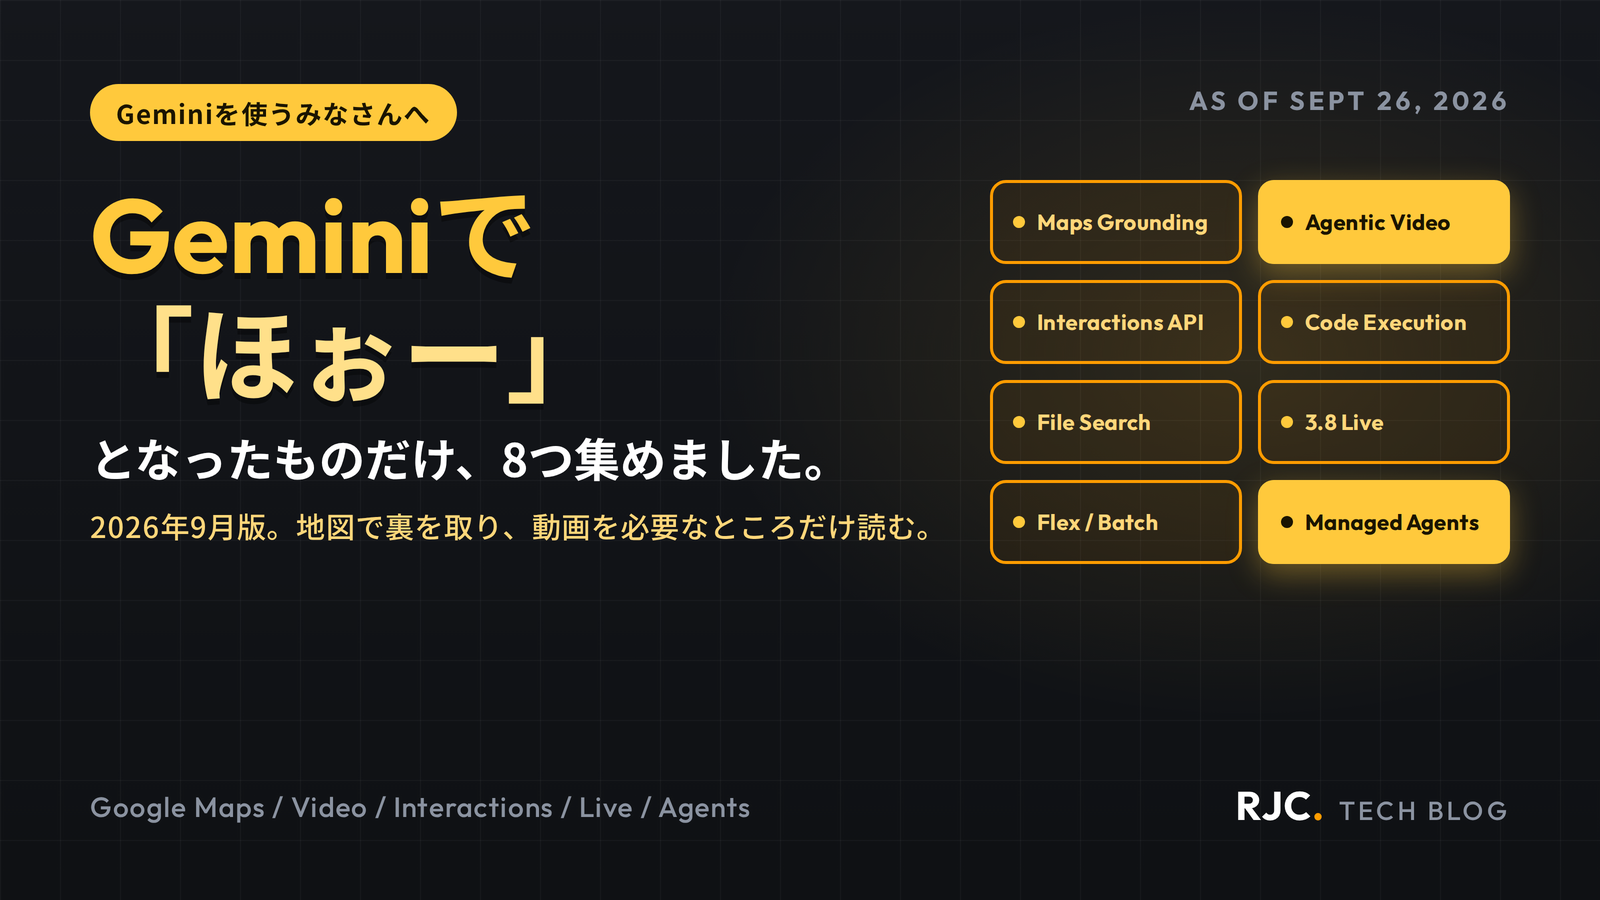
今回は、調べていて「ほぉー」となったものを8つ集めました。8月に一度まとめたものを、Gemini APIの公式リリースノート(2026年9月24日更新)をもとに、2026年9月26日時点の内容に書き直しています。地図で裏を取る、動画を必要なところだけ読む、サンドボックス付きのエージェントを借りる。1つでも知らなかったら儲けものです。異論・追加も大歓迎です。
① 地図で、回答の裏を取れます
これはGeminiならではだなと思いました。Google検索で回答を裏付ける機能は他にもありますが、GeminiにはGoogle Mapsによるグラウンディングがあるんです(2025年10月に一般提供、2026年3月からGemini 3系のモデルでも対応)。
つまり、位置情報を根拠にして答えを組み立てられる。「この住所の周辺にある同業他社は」「この2拠点間の移動時間を踏まえた提案を」。こういう問いに、実在するデータを参照して答えられるということですね。
営業の提案資料、出店の検討、配送計画。地図の情報が絡む業務なら、かなり効いてくる領域かなと思います。2026年3月からは、こうした組み込みツールと自作の関数呼び出しを1回の呼び出しで同時に使えるようにもなっています。
② 長い動画は、必要なところだけ読みます
テキストや画像だけでなく、動画そのものを入力できるのはGeminiの持ち味でした。公開YouTubeのURLをそのまま渡すこともできます。
そして2026年9月1日に、読み方そのものが変わりました。エージェントによる動画の理解です。動画を最初から最後まで一定間隔で読むのではなく、モデルが動画のタイムラインを自分で移動して、必要な場面の文字起こし・フレーム・音声だけをその都度取りに行く。長尺コンテンツでは、従来の静的な処理に比べてトークン使用量を最大88%削減できるとされています。
「3分20秒あたりで説明されている手順を、箇条書きにして」。会議の録画、操作の説明動画、現場を撮影した記録。これまでなら文字起こしを作ってから読ませていた工程が、そのまま渡せて、しかも長くても安い。前処理が減るだけでなく、財布にも効くようになりました。
③ 会話の履歴を、サーバー側に持てます
これは仕組みの話ですが、設計が変わるやつです。
AIとの会話は、本来「新しいメッセージを送るたびに、それまでの会話全部を一緒に送り直す」仕組みですよね。会話が長くなるほど毎回送る量が増える。
2026年6月に一般提供になったInteractions APIには、サーバー側で会話状態を保持する仕組みがあります。直前のやり取りのIDを渡すだけで続きから話せるので、履歴を丸ごと送り直さなくていいんですよね。さらに、時間のかかる処理をバックグラウンドで実行して後から結果を取りに行く、実行ステップをモニタリングしてUIに出す、といった機能も用意されています。
Googleは新規プロジェクトにはこのInteractions APIを推奨していて、従来のgenerateContent APIは「引き続きサポートされるがレガシー」という位置づけです。これから作るなら、こちらで始めるのが正解です。
④ 自分でコードを書いて、実行して答えます
これは仕組みが面白いところです。Code Executionという機能があって、モデルが自分でPythonを書いて、サンドボックス内で実行し、その結果を使って回答します。
たとえば複雑な計算を頼んだとき。言語モデルは本来、数値計算が得意ではないんですよね。「それっぽい数字」を出してしまうことがある。でもCode Executionが有効なら、計算はコードにやらせるんです。実行結果が返ってくるので、答えが合っている。グラフを描かせて画像で返す、大量データを集計する、暗号を検証する。
曖昧な部分はモデルに、正確さが必要な部分はコードに。この役割分担が、機能として組み込まれているのが面白いなと思います。
⑤ RAGの仕組みが最初から入っていて、画像も検索できます
社内文書をAIに答えさせたい。普通なら、文書を分割して、ベクトル化して、データベースに入れて、検索する仕組みを作る……という工程が要りますよね。
GeminiにはFile Searchがあって、この一連が機能として提供されています。ファイルをアップロードしておけば、質問に応じて関連部分を探して回答してくれる。
ここが2026年に一段進みました。テキスト・画像・動画・音声・PDFを同じベクトル空間に置けるgemini-embedding-2(4月に一般提供)を使って、5月からFile Searchが画像もそのまま検索対象になったんです。回答の根拠として、どの画像(media_id)の何ページ目(page_numbers)を見たかも返ってきます。
「夕方の街並みで、人が写っていない写真」のような問いで画像を直接探せる。設計書のPDFと現場写真がバラバラに管理されている状況でも、横断して探せる。自前でベクトルデータベースを立てなくていいというのは、小さく始めるときにかなり大きいんですよね。
⑥ 声で聞いて、声で返します。考えながら
Live APIという、リアルタイムの音声・映像対話の仕組みがあります。2026年9月15日に、その中核となる音声から音声へのモデルGemini 3.8 Liveが一般提供になりました。
面白いのが「考えながら話す」設計です。推論による遅延を感じさせない低レイテンシを保ちつつ、推論を会話に織り込む(インターリーブ推論)。関数呼び出しは既定で非同期になっていて、ツールを呼んでいる間も会話が止まりません。より深い推論が要る用途には、会話の裏側でバックグラウンド推論を回すGemini 3.8 Live Extended Thinkingも用意されています。
周辺も揃ってきました。8月には85以上の言語で話者分離と単語単位のタイムスタンプが取れるGemini 3.5 Transcribe(ストリーミング版もあり)、9月には150以上の音声とカスタム音声を扱える新しいTTSモデル。音声アシスタント、コールセンターの一次対応、操作しながらの案内。「聞いて、考えて、返す」を待たせずに組める部品が、一通り揃った感じです。
⑦ 急がない処理は、まとめて安く投げられます
即座に返ってこなくていい処理を、まとめて非同期で投げるBatch APIがあります。大量の文書を分類する、蓄積したレビューを一括で要約する、過去ログにタグを付ける。夜間にまとめて処理して、朝に結果を受け取る。それで困らないなら、通常より安く実行できます。
2026年に、この「急ぎ度で単価を変える」考え方が広がりました。4月にFlex推論ティア(費用を優先)とPriority推論ティア(レイテンシを優先)が導入され、同じモデルでも用途に応じて選べるようになっています。5月からはWebhookで完了を通知してもらえるので、バッチや長時間処理の結果をポーリングで待つ必要もなくなりました。
同じ長文を前提に何度も質問するならコンテキストキャッシュも効きます。一度送った仕様書やマニュアルをキャッシュとして保持し、2回目以降はそれを参照する形です。
cache = client.caches.create(
    model="...",
    config={
        "contents": [長い仕様書],
        "ttl": "3600s",           # 保持時間
    },
)

# 以降は、キャッシュを指定して質問するだけ
response = client.models.generate_content(
    model="...",
    contents="第3章の要件をまとめて",
    config={"cached_content": cache.name},
)
バッチ×キャッシュ×Flexを組み合わせると、「同じ前提×大量件数×急がない」処理のコストはかなり変わってきます。削減率は使い方によるので、自分の想定で試算するのがおすすめです。
⑧ サンドボックス付きのエージェントを、そのまま借りられます
最後は、2026年でいちばん大きな変化です。
5月に公開プレビューになったManaged Agentsは、Googleがホストする隔離されたLinuxサンドボックスの中で動く、自律的でステートフルなエージェントを構築・デプロイできる仕組みです。汎用のAntigravity Agentは、そのサンドボックス内でコードの計画・推論・記述・実行、ファイルの管理、ウェブの閲覧までを自律的に行います。9月17日には新バージョン(09-2026)が出て、ファイル編集が全文書き換えから行範囲の置換に変わるなど、ツールも実務寄りに更新されました。
調査に特化したDeep Researchエージェントもあり、4月の版では計画を人と共同で練る機能、可視化、MCPサーバーの統合、File Searchとの連携が入っています。エージェントに認証情報を渡す仕組みや、ツール実行の前後に処理を挟むHooksもドキュメント化されています。
つまり「エージェントの実行環境を自分で用意する」工程を、まるごと任せられるということなんですよね。試す段階では、これがいちばん速い入口だと思います。
番外編:モデルの入れ替わりが速いです
便利な話が続いたので、注意点も書いておきますね。Geminiは機能追加が速い反面、モデルの非推奨とシャットダウンも頻繁にあります。2026年だけでも、こんな調子です。
- 6月1日:Gemini 2.0系がシャットダウン
- 6月30日:Veo 3.0系がシャットダウン、8月17日:Imagen 4系がシャットダウン
- 7月21日:サンプリングパラメータ temperature / top_p / top_k が非推奨に
- 9月18日:Gemini 2.5系へのアクセスが、過去に使っていたユーザーに限定(新規は3.5 Flash-Liteか3.8 Flashへ)
- 10月5日:Antigravity Agentの05-2026版が終了予定
Flashモデルも3.5(5月)→3.6・3.5 Flash-Lite(7月)→3.7(8月)→3.8(9月)と、ほぼ毎月更新されています。つまり一度作ったら終わり、にはならないということです。
対策としては、モデル名を設定ファイルの外に出しておく。差し替えられる構造にしておく。そしてリリースノートを定期的に見る習慣をつける。ここは運用として組み込んでおくと安心です。
よくいただくご質問
Q. どれから試すのがいいですか?
A. ②の動画かなと思います。録画データがあれば、すぐ試せます。前処理なしで渡せる体験は、一度やると戻れないんですよね。
Q. 他のモデルと、どう使い分けますか?
A. どれが賢いかより、そのタスクに必要な機能があるかで選ぶのがいいと思います。地図や動画、音声対話が絡むならGeminiが候補に入りますね。
Q. 無料で試せますか?
A. 試せる枠があります。ただし条件は変わることがあるので、公式の最新情報を確認してください。
Q. 未経験からでも、こういうAPIを扱えますか?
A. 扱えます。「渡して、返ってきたものを使う」という構造はどのAPIでも同じなんですよね。
「何ができるか」を知っていると、選択肢が増えます
今日の8つを並べてみて思ったのが、これでした。モデルの賢さを比べる話はよく見かけますが、そもそも何ができるかは、モデルごとにかなり違うんですよね。
地図で裏を取れる。動画を必要なところだけ読める。会話をサーバー側に預けられる。サンドボックス付きのエージェントを借りられる。知らなければ、そもそも選択肢に入りません。
「どれが一番賢いか」より「この仕事に必要な機能を持っているのはどれか」。そう考えると、選び方が変わってきます。
みなさんの「これも便利だよ」も、ぜひ教えてください。
参考:Google AI for Developers「Gemini API リリースノート」(2026年9月24日更新)/同「Interactions API」「エージェントによる動画の理解」「ファイル検索」「Live API」「Flex推論」「Managed Agents」各ドキュメント(2026年9月26日確認)
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。




