- MySQL

MySQL Deadlock foundの原因と対処|1213・1205


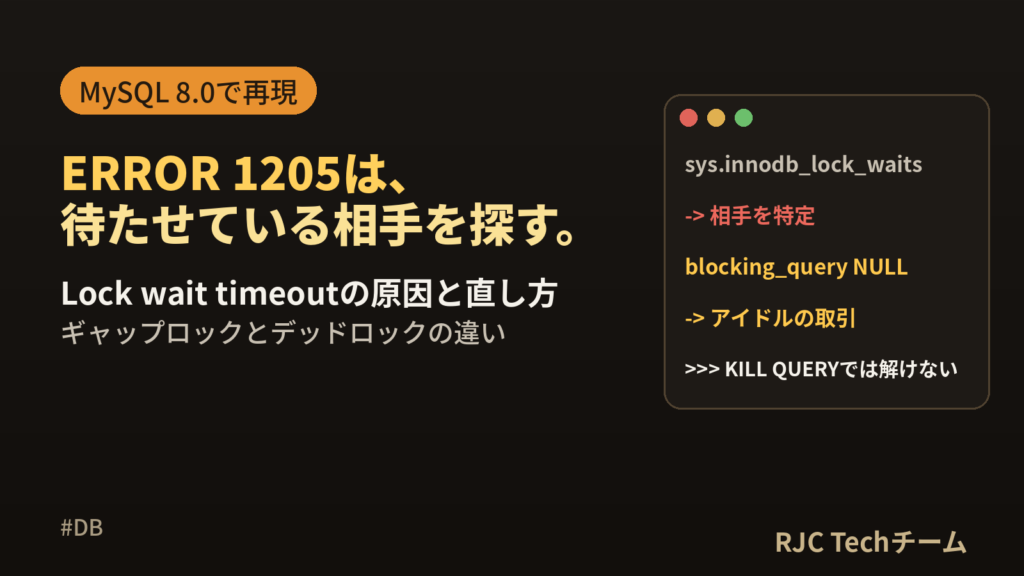
ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction は、2つのトランザクションが互いに相手のロックを待ち、どちらも進めなくなったため、MySQL が片方を取り消したときのエラーです。 似たエラーの 1205 とは、意味も、取り消される範囲も違います。
| 1213 Deadlock found | 1205 Lock wait timeout exceeded | |
|---|---|---|
| 起きたこと | 互いに待ち合って進めない(デッドロック) | 相手のロックが外れるのを待ち続け、時間切れ |
| いつ出るか | すぐ(MySQL が検出して片方を取り消す) | innodb_lock_wait_timeout 秒後(既定は 50 秒) |
| 取り消される範囲 | トランザクション全体 | その SQL 文だけ(それより前の更新は残る) |
| 多い原因 | 更新の順番が処理によって違う | COMMIT し忘れた接続、インデックスが無い更新、長いトランザクション |
| 対処 | 順番をそろえる+リトライ | ロックを持ち続けている接続を探す+インデックス |
確認環境:MySQL 8.0.46(InnoDB、分離レベル REPEATABLE-READ)、Python 3.11(PyMySQL 2.2.8)、Java 21(MariaDB Connector/J 2.7.6)(確認日 2026年10月11日)。2つの接続を同時に動かして再現しました。
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「MySQL Deadlock foundの原因と対処|1213・1205」
再現:1213 デッドロック
口座 id=1 と id=2 の間で、2つの処理が逆向きに振り込みます。
| 時刻 | トランザクション A(1→2) | トランザクション B(2→1) |
|---|---|---|
| 1 | UPDATE ... WHERE id=1(id=1 をロック) |
|
| 2 | UPDATE ... WHERE id=2(id=2 をロック) |
|
| 3 | UPDATE ... WHERE id=2 → B を待つ |
|
| 4 | UPDATE ... WHERE id=1 → A を待つ → デッドロック |
ERROR 1213 (40001) at line 4: Deadlock found when trying to get lock; try restarting transaction
A: id=1 をロック
B: id=2 をロック
A: id=2 も更新
B: (1213, 'Deadlock found when trying to get lock; try restarting transaction')
A: COMMIT
((1, 900), (2, 1100))         ← A の振り込みだけが反映。B は全体が取り消された
B のトランザクションは全体が取り消されています(B の最初の id=2 の更新も無かったことになる)。エラー文の try restarting transaction のとおり、トランザクションを最初からやり直すのが MySQL の想定です。
原因を調べる:SHOW ENGINE INNODB STATUS
直近のデッドロックの詳細は、SHOW ENGINE INNODB STATUS\G の LATEST DETECTED DEADLOCK に残ります。
LATEST DETECTED DEADLOCK
------------------------
*** (1) TRANSACTION:
TRANSACTION 4413, ACTIVE 1 sec starting index read
update account set balance=balance+100 where id=2              ← (1) が待っていた SQL

*** (1) HOLDS THE LOCK(S):
RECORD LOCKS ... index PRIMARY of table `dl`.`account` ... lock_mode X locks rec but not gap
 0: len 4; hex 80000001; ...                                    ← (1) は id=1 のロックを持っている

*** (1) WAITING FOR THIS LOCK TO BE GRANTED:
 0: len 4; hex 80000002; ...                                    ← (1) は id=2 を待っている

*** (2) TRANSACTION:
update account set balance=balance+100 where id=1              ← (2) が待っていた SQL
*** (2) HOLDS THE LOCK(S):        ... hex 80000002              ← (2) は id=2 を持っている
*** (2) WAITING FOR THIS LOCK ...  ... hex 80000001              ← (2) は id=1 を待っている

*** WE ROLL BACK TRANSACTION (2)                                ← (2) が取り消された
| 見る場所 | 分かること |
|---|---|
TRANSACTION の下の SQL |
それぞれが待っていたSQL |
HOLDS THE LOCK(S) |
持っているロック。index PRIMARY of table でテーブルとインデックスが分かる |
hex 80000001 |
ロックした行のキー。INT の主キーなら、先頭の 8 を除いた値(00000001 → id=1) |
WE ROLL BACK TRANSACTION (2) |
取り消された側 |
「(1) が持っているもの」を「(2) が待っている」、その逆も成り立つのがデッドロックです。表示されるのは直近の1件だけなので、何度も起きるなら、MySQL 公式マニュアルにある innodb_print_all_deadlocks を一時的に ON にして、エラーログにすべて記録します。
対処1:更新の順番をそろえる
デッドロックは、処理によってロックを取る順番が違うと起きます。確認環境で、A と B の両方を「id の小さい順(1→2)」で更新するようにすると、B は A の COMMIT を待ってから進み、デッドロックは起きませんでした。
A: id=1 をロック
A: id=2 も更新
A: COMMIT
B: id=1 をロック              ← A の COMMIT まで待ってから進んだ
B: id=2 も更新
B: COMMIT
((1, 800), (2, 1200))         ← 両方とも反映
| 順番をそろえる方法 | 例 |
|---|---|
| 主キーの小さい順に更新する | 振り込みなら「送金元・送金先」ではなく「id の小さい口座から」 |
| 先に必要な行をまとめてロックする | SELECT ... WHERE id IN (1, 2) ORDER BY id FOR UPDATE |
| 複数のテーブルは、いつも同じ順番で | 注文 → 在庫 → ポイント、のように決めておく |
MySQL 公式マニュアルでも、複数のテーブルや行を更新するときは毎回同じ順番で行うよう案内されています。
対処2:リトライを実装する
順番をそろえても、デッドロックを完全になくすのは難しいため、1213 が出たらトランザクションを最初からやり直す処理を入れておきます。MySQL 公式マニュアルも「デッドロックは危険ではなく、やり直せばよい。いつでもやり直せるように作る」としています。
Python(PyMySQL)
import time, random, pymysql

RETRYABLE = {1213, 1205}   # デッドロック、ロック待ちのタイムアウト

def transfer(db, src, dst, amount, max_retry=3):
    for attempt in range(1, max_retry + 1):
        try:
            with db.cursor() as cur:
                cur.execute("UPDATE account SET balance = balance - %s WHERE id = %s", (amount, src))
                cur.execute("UPDATE account SET balance = balance + %s WHERE id = %s", (amount, dst))
            db.commit()
            return attempt
        except pymysql.err.OperationalError as e:
            db.rollback()                                    # 必ずロールバックしてから
            if e.args[0] not in RETRYABLE or attempt == max_retry:
                raise
            time.sleep(random.uniform(0.1, 0.3) * attempt)   # 少し待ってからやり直す
  1213 が発生、1回目をやり直します
試行回数: {'A': 1, 'B': 2}
((1, 1000), (2, 1000))        ← A は 1 回、B は 2 回目で成功。両方の振り込みが正しく反映
Java(JDBC)
} catch (SQLException e) {
    con.rollback();
    boolean retryable = e.getErrorCode() == 1213 || e.getErrorCode() == 1205;
    if (!retryable || attempt >= 3) throw e;
    Thread.sleep(200L * attempt);          // 少し待ってから、トランザクションを最初からやり直す
}
  1213 (SQLState 40001) が発生、1回目をやり直します
試行回数: A=1 B=2
| リトライの注意点 | 理由 |
|---|---|
| トランザクション全体をやり直す | 1213 では全体が取り消されている。最後の SQL だけ再実行しても足りない |
| rollback してからやり直す | 1205 では前の更新が残っているため |
| 回数に上限をつけ、少し待つ | すぐやり直すと、同じ相手とまたぶつかる |
| やり直しても問題ない処理にする | メール送信や外部 API の呼び出しを、トランザクションの中に入れない |
Spring を使っている場合も、@Transactional のメソッド全体をやり直す形にします(メソッドの中の1文だけをやり直さない)。
再現:1205 Lock wait timeout exceeded
COMMIT していない接続がロックを持ったままだと、ほかの接続は待ち続け、innodb_lock_wait_timeout 秒(確認環境の既定値は 50)で 1205 になります。
(接続1)UPDATE account ... WHERE id=1;   ← COMMIT しないまま放置
(接続2)UPDATE account ... WHERE id=2;   ← 成功
(接続2)UPDATE account ... WHERE id=1;   ← 接続1を待つ
3.0秒後: (1205, 'Lock wait timeout exceeded; try restarting transaction')   ← 待ち時間を 3 秒にして再現
タイムアウト後、同じトランザクションの id=2: ((2, 1005),)                   ← 前の更新は残っている
1205 では、時間切れになった SQL 文だけが取り消され、トランザクションの前の更新は残りました(確認環境の innodb_rollback_on_timeout は 0)。そのまま COMMIT すると、途中までの更新だけが確定します。1205 を受け取ったら、rollback してからやり直します。
止めている接続を探す
SELECT waiting_pid, waiting_query, blocking_pid, blocking_query, wait_age, sql_kill_blocking_connection
FROM sys.innodb_lock_waits\G
                 waiting_pid: 29
               waiting_query: update account set balance=balance+5 where id=1
                blocking_pid: 28
              blocking_query: NULL                         ← 止めている側は、今は何も実行していない
                    wait_age: 00:00:01
sql_kill_blocking_connection: KILL 28
blocking_query が NULL なのは、止めている接続が SQL を実行し終えたあと、COMMIT も ROLLBACK もせずに止まっている状態です。1205 の原因として最も多いパターンで、次のようなときに起きます。
| 状況 | 例 |
|---|---|
| 手作業の接続を開いたまま | ツールで UPDATE して、COMMIT せずに席を離れた(自動コミットが OFF の設定) |
| アプリが例外で抜けて、rollback していない | プールに戻った接続が、トランザクションの途中のまま |
| トランザクションの中で時間のかかる処理 | 外部 API・ファイル処理を、トランザクションの中で実行している |
KILL 28 で止められますが、その接続の未確定の更新は取り消されます。誰の接続かを確かめてから実行します。
対処3:インデックスを付ける
WHERE の列にインデックスが無いと、関係ない行までロックされます。 100 行の注文テーブルで、cust=1 の行を更新中(未 COMMIT)に、別の接続で cust=2 の行を更新しました。
cust 列 |
別の接続の UPDATE ... WHERE cust=2 |
|---|---|
| インデックスなし | 1205 Lock wait timeout exceeded(2 秒で時間切れに設定) |
| インデックスあり | 成功(20 行、0.00 秒) |
インデックスが無いと、条件に合う行を探すためにテーブル全体を読み、読んだ行すべてにロックがかかるため、別の顧客の行の更新まで待たされました。UPDATE・DELETE・SELECT ... FOR UPDATE の WHERE の列には、EXPLAIN でインデックスが使われているかを確かめます。
確認の手順(チェックリスト)
| 順番 | 確認すること | 方法 |
|---|---|---|
| 1 | 1213 か 1205 か | 1213 はデッドロック、1205 は待ち時間切れ |
| 2 | デッドロックした SQL とロック | SHOW ENGINE INNODB STATUS\G の LATEST DETECTED DEADLOCK |
| 3 | 止めている接続 | sys.innodb_lock_waits の blocking_pid・blocking_query |
| 4 | 更新の順番 | 処理によって順番が逆になっていないか |
| 5 | WHERE の列のインデックス | EXPLAIN で確かめる |
| 6 | トランザクションの長さ | 外部 API・ファイル処理を外に出す |
| 7 | リトライ | 1213・1205 で rollback → トランザクション全体をやり直す |
よくある質問
Q. innodb_lock_wait_timeout を長くすれば直りますか。 A. 1205 が出るまでの時間が延びるだけで、ロックを持ち続けている原因は残ります。待っている間は処理が止まるので、まず止めている接続とトランザクションの長さを確かめます。デッドロック(1213)はすぐに検出されるため、この設定は関係ありません。
Q. デッドロックは異常ですか。 A. 同時に更新する処理があれば、起きうるものです。MySQL 公式マニュアルでも、頻繁でなければ危険ではないとされています。リトライで正しく処理できるようにし、回数が多いときに順番とインデックスを見直します。
まとめ
- 1213 は互いの待ち合い。トランザクション全体が取り消されるので、最初からやり直す
- 1205 は待ち時間切れ。取り消されるのはその SQL 文だけ。rollback してからやり直す
- 原因は
SHOW ENGINE INNODB STATUSとsys.innodb_lock_waitsで調べる - 更新の順番をそろえると、デッドロックは待ち行列になる
blocking_queryが NULL なら、COMMIT し忘れた接続- WHERE の列にインデックスが無いと、関係ない行までロックされる
参考・出典
確認日はいずれも 2026年10月11日です。
- MySQL 8.0 Reference Manual「How to Minimize and Handle Deadlocks」:https://dev.mysql.com/doc/refman/8.0/en/innodb-deadlocks-handling.html
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「MySQL Deadlock foundの原因と対処|1213・1205」
株式会社RJC ― SI事業・SES事業・AI駆動開発。RJCは一緒に成長を楽しめる会社です。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。