- Linux
Linux topコマンドの見方 全項目の意味と操作キー早見表


topコマンドとは、CPU・メモリの使用状況と、負荷の高いプロセスを数秒ごとに更新しながら一覧表示するLinuxの標準コマンドです。 画面は「上の5行(ヘッダー)=サーバー全体の状態」と「下の表(プロセス欄)=プロセスごとの内訳」の2段構成になっていて、この2つを順に読めば「いま何が重いのか」がわかります。
この記事では、Ubuntu 24.04(procps-ng 4.0.4)で実際に動かした top の画面を1行ずつ注釈し、全項目の意味、操作キー、load average の判定目安、wa・st が高いときに次に打つコマンドまでを一気に確認できるようにしました。操作キーは tmux の中で実際に押して表示の変化を確かめたものに「確認済み」の印を付けています。スクリプトに貼って使える top -b -n 1 の例と、htop・btop との対応表も載せています。
topコマンドの早見表
まずは「どこを見て、何を押すか」を1枚にまとめます。
| 知りたいこと | 見る場所・押すキー | 読み方の目安 |
|---|---|---|
| サーバーが混んでいるか | 1行目 load average | コア数で割って 1.0 を超えると順番待ちが発生 |
| CPUを何が使っているか | 3行目 us / sy / ni | us=アプリ、sy=カーネル、ni=nice値を変えたプロセス |
| ディスク待ちか | 3行目 wa | 高いときは iostat -x 1 で確認 |
| 仮想マシンの取り合いか | 3行目 st | 高いときはホスト側の混雑を疑う |
| メモリが足りているか | 5行目 avail Mem | free ではなく avail Mem を見る |
| CPU使用率の高い順 | P(初期状態) | %CPU は1コア=100% |
| メモリ使用量の多い順 | M | %MEM と RES を見る |
| CPU時間の累計順 | T | 長時間動いているプロセス探し |
| コアごとの使用率 | 1 | 1コアだけ張り付いていないか |
| コマンドの引数まで表示 | c | 同名プロセスの見分け |
| 親子関係をツリー表示 | V | どのプロセスが起動したか |
| スレッド単位で表示 | H | 1行目が Tasks から Threads に変わる |
| 表示する列・ソート列を選ぶ | f | d で表示切替、s でソート列指定 |
| プロセスにシグナルを送る | k | PID とシグナルを入力 |
| いまの設定を保存 | W | ~/.config/procps/toprc に書き出し |
| 1回だけ出力して終了 | top -b -n 1 | ログ保存・スクリプト用 |
| 終了 | q |
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「Linux topコマンドの見方 全項目の意味と操作キー早見表」
検証した環境
| 項目 | 内容 |
|---|---|
| OS | Ubuntu 24.04.4 LTS |
| top | procps-ng 4.0.4(top -V で表示) |
| CPU / メモリ | 2コア / 約8GB、スワップなし |
| 関連ツール | vmstat(procps-ng 4.0.4)、iostat(sysstat 12.6.1)、htop 3.3.0、btop 1.3.0 |
RHEL系やAmazon Linuxでも top は procps-ng 由来で、基本の読み方は共通です。バージョンによって表示の細部(メモリの単位や used の計算方法など)が異なるため、手元の版は top -V で確認しておくと安心です。macOS の top は別の実装で、画面もオプションも異なります(今回は未実行のため扱いません)。
実際のtop画面を1行ずつ読む
次の出力は、CPUを使い続けるシェルを1つ動かした状態で top -b -n 1 を実行したものです(プロセス欄は一部の行を抜粋しています)。
top - 13:32:01 up 5 min,  0 user,  load average: 5.52, 1.89, 0.67
Tasks:  73 total,   3 running,  70 sleeping,   0 stopped,   0 zombie
%Cpu(s):  4.4 us,  1.5 sy, 48.5 ni,  0.0 id, 44.1 wa,  0.0 hi,  1.5 si,  0.0 st
MiB Mem :   8031.1 total,   5241.7 free,   1215.8 used,   1848.0 buff/cache
MiB Swap:      0.0 total,      0.0 free,      0.0 used.   6815.3 avail Mem

  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
 2121 root      35  15    2828   1856   1728 R 100.0   0.0   0:02.32 sh
 2123 root      20   0 1341448 221344  51540 S  30.0   2.7   0:00.79 npm i rea+
    1 root      20   0   22492   5312   4908 S   0.0   0.1   0:00.72 process_a+
    2 root      20   0       0      0      0 S   0.0   0.0   0:00.00 kthreadd
    4 root       0 -20       0      0      0 I   0.0   0.0   0:00.00 kworker/R+
この画面から読み取れることを先に言葉にすると、次のようになります。
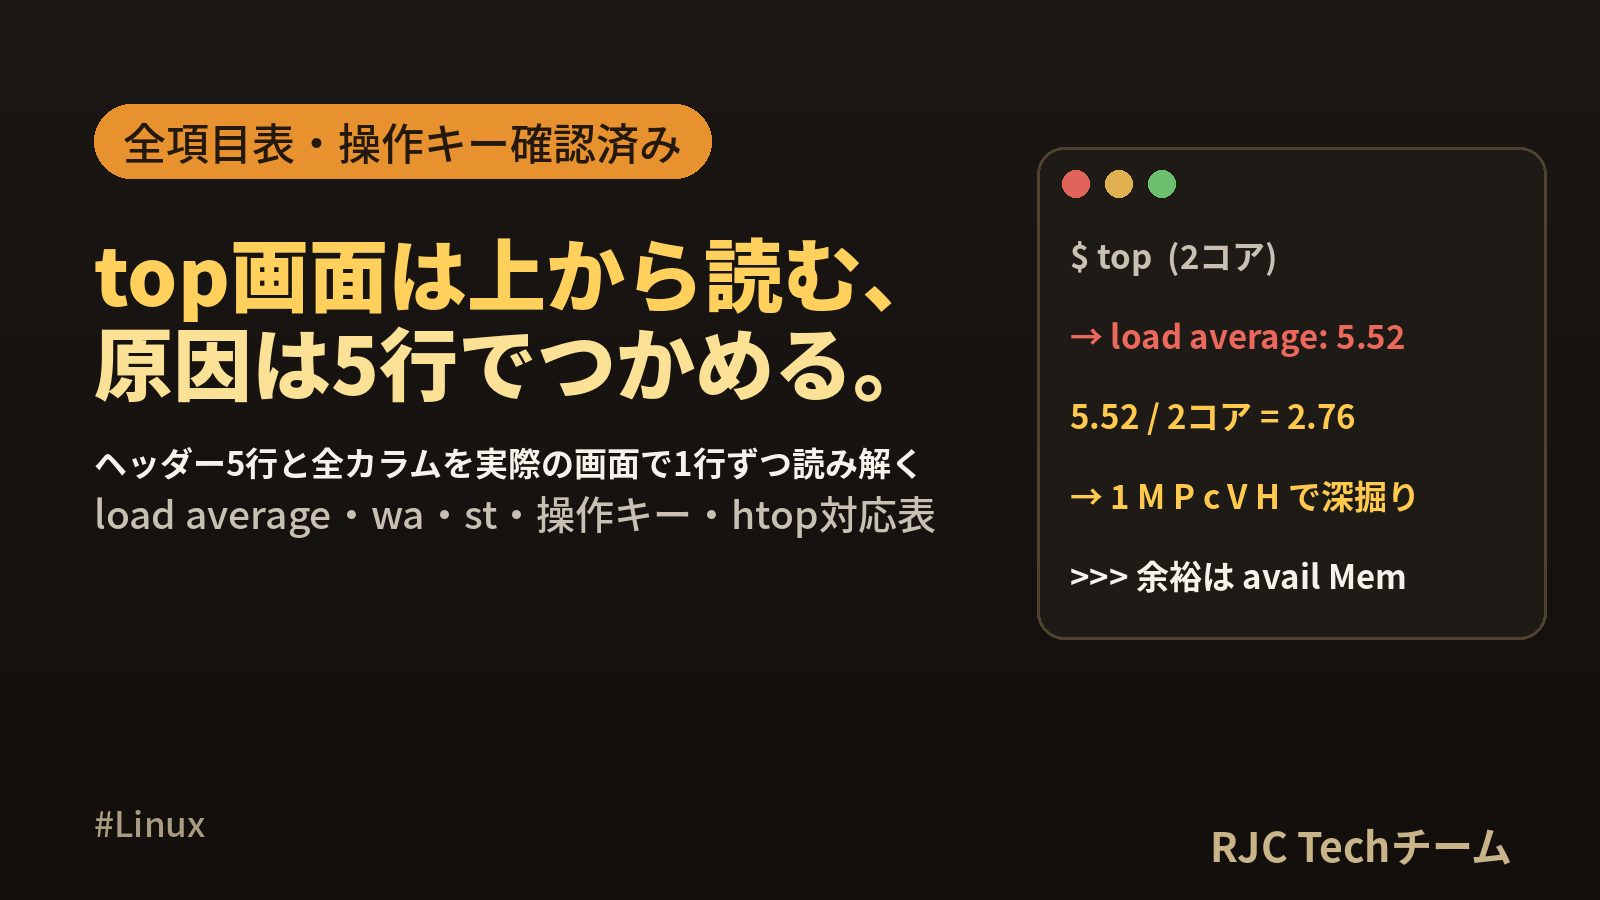
- load average 5.52 を 2コアで割ると 2.76。直近1分はコア数の2倍を超える仕事が並んでいる
- 5分平均は 1.89、15分平均は 0.67 なので、混み始めたのはごく最近
- CPU は ni が 48.5%、wa が 44.1%。nice値を変えたプロセスが1コアを使い、もう1コアはディスク待ち
- メモリは avail Mem が 6815.3MiB あり、余裕がある
- プロセス欄の先頭は PID 2121 の sh で、%CPU 100.0(1コアを使い切り)、NI が 15
このように、ヘッダーで全体の傾向をつかみ、プロセス欄で原因のプロセスを特定するのが top の基本の流れです。
ヘッダー5行の全項目
1行目:稼働時間と load average
top - 13:32:01 up 5 min, 0 user, load average: 5.52, 1.89, 0.67
| 表示 | 意味 |
|---|---|
| 13:32:01 | 現在時刻 |
| up 5 min | 起動してからの時間(長いと up 12 days, 3:40 のような形式) |
| 0 user | ログイン中のユーザー数 |
| load average: 5.52, 1.89, 0.67 | 左から 直近1分・5分・15分 の平均負荷 |
uptime コマンドと同じ内容です。同じタイミングで uptime を実行すると、次のように一致しました。
$ uptime
 13:32:02 up 5 min,  0 user,  load average: 5.52, 1.89, 0.67
2行目:タスクの数と状態
Tasks: 73 total, 3 running, 70 sleeping, 0 stopped, 0 zombie
| 表示 | 意味 | 見るポイント |
|---|---|---|
| total | プロセスの総数 | 急に増えていないか |
| running | 実行中・実行待ち | コア数を大きく超える状態が続くと混雑 |
| sleeping | 待機中 | 大半がここに入るのが通常 |
| stopped | 一時停止中(Ctrl+Z など) | 止めたまま忘れたジョブがないか |
| zombie | 終了したが親が後始末していない | 少数なら影響は小さい。増え続けるなら親プロセスを確認 |
H キー(または -H オプション)でスレッド表示にすると、この行の見出しが Tasks から Threads に変わります。
3行目:CPU使用率の内訳
%Cpu(s): 4.4 us, 1.5 sy, 48.5 ni, 0.0 id, 44.1 wa, 0.0 hi, 1.5 si, 0.0 st
8つの値を合計するとほぼ100%になります。 全コアの平均である点に注意してください。
| 項目 | 何に使った時間か | 高いときに考えること |
|---|---|---|
| us(user) | アプリケーションの処理(nice値を変えていないもの) | プロセス欄で %CPU の高いプロセスを確認 |
| sy(system) | カーネルの処理(システムコール、プロセス切り替えなど) | 入出力やプロセス生成が多すぎないか |
| ni(nice) | nice値を上げた(優先度を下げた)プロセスの処理 | バッチ処理などが動いている。多くは想定どおり |
| id(idle) | 何もしていない時間 | 大きいほど余裕がある |
| wa(iowait) | ディスクなどの入出力完了を待っていた時間 | iostat -x 1 でデバイスを確認 |
| hi | ハードウェア割り込みの処理 | 通常はほぼ 0 |
| si | ソフトウェア割り込みの処理 | ネットワーク通信が非常に多いと上がる |
| st(steal) | 仮想マシンで、ホスト側に取られて使えなかった時間 | 同じホスト上の他の仮想マシンの影響を確認 |
4・5行目:メモリとスワップ
MiB Mem :   8031.1 total,   5241.7 free,   1215.8 used,   1848.0 buff/cache
MiB Swap:      0.0 total,      0.0 free,      0.0 used.   6815.3 avail Mem
| 項目 | 意味 |
|---|---|
| total | 搭載メモリの合計 |
| free | まったく使われていないメモリ |
| used | 使用中のメモリ |
| buff/cache | ファイルの読み書きを速くするためのキャッシュ。必要になれば解放される |
| Swap total / free / used | スワップ領域の合計・空き・使用量 |
| avail Mem | 新しいプロセスが使える見込みのメモリ(/proc/meminfo の MemAvailable) |
メモリの余裕は free ではなく avail Mem で判断します。 Linux は空いているメモリを積極的にキャッシュに使うため、free が小さくても、avail Mem が十分あれば問題ありません。avail Mem は5行目(Swapの行)の右端にあるため見落としやすい項目です。
もう1つ、今回の環境で確かめた点があります。procps-ng 4.0.4 では used は「total − available」で計算されているため、free・used・buff/cache を足しても total にはなりません。
$ free -m
               total        used        free      shared  buff/cache   available
Mem:            8031        1703        4118          90        2555        6327
8031 − 6327 = 1704 で used(1703)とほぼ一致し、4118 + 1703 + 2555 = 8376 は total を上回ります。版によって計算が違うため、「足して合わない」と感じたらこの違いを思い出してください。
プロセス欄の全カラム
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
 2121 root      35  15    2828   1856   1728 R 100.0   0.0   0:02.32 sh
  581 mysql     25   5 1782132 396036  36520 S   0.0   4.8   0:00.91 mysqld
    4 root       0 -20       0      0      0 I   0.0   0.0   0:00.00 kworker/R+
| カラム | 意味 | 読み方 |
|---|---|---|
| PID | プロセスID | kill や -p で指定する番号 |
| USER | 実効ユーザー名 | 長い名前は末尾が + で省略される |
| PR | カーネルから見た優先度 | 通常のプロセスは 20 + NI。rt はリアルタイム優先度 |
| NI | nice値(−20〜19) | 小さいほど優先度が高い。既定は 0 |
| VIRT | 仮想メモリの合計(KiB) | 予約しただけの領域も含む。大きくても心配は不要 |
| RES | 物理メモリを使っている量(KiB) | メモリ消費の実体。まずここを見る |
| SHR | RES のうち他プロセスと共有できる分(KiB) | 共有ライブラリや共有メモリ |
| S | プロセスの状態 | 下の表を参照 |
| %CPU | 前回更新からのCPU使用率 | 1コア=100%。4コアを使い切ると 400% |
| %MEM | 物理メモリに対する RES の割合 | |
| TIME+ | 起動してから使ったCPU時間の累計 | 分:秒.1/100秒。0:02.32 は 2.32秒 |
| COMMAND | コマンド名 | c で引数つきの表示に切り替え |
PR と NI の関係
上の出力で、NI が 15 の sh は PR が 35、NI が 5 の mysqld は PR が 25、NI が −20 の kworker は PR が 0 です。PR = 20 + NI という関係がそのまま確認できます。別のプロセスを NI 5 にして確かめた結果も同じでした。
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
 3897 root      25   5    2724   1768   1648 S   0.0   0.0   0:00.00 sleep
nice値を上げたプロセスは、ほかに仕事があるときに順番を譲ります。3行目の ni が高いのは「譲る設定のプロセスが、空いているCPUを使っている」状態で、多くの場合は想定どおりの動きです。
VIRT・RES・SHR の違い
| 列 | たとえると | 例(mysqld) |
|---|---|---|
| VIRT | 予約した座席数 | 1782132 KiB(約1.7GiB) |
| RES | 実際に座っている人数 | 396036 KiB(約387MiB) |
| SHR | そのうち相席できる分 | 36520 KiB(約36MiB) |
VIRT はプログラムが「使うかもしれない」と確保した範囲で、実際に物理メモリを使っているのは RES です。メモリ不足を調べるときは RES と %MEM を見ます。 数字が大きくて読みにくいときは e キーで単位を切り替えられます(後述)。
S(状態)の一覧
| 表示 | 状態 | 説明 |
|---|---|---|
| R | running | 実行中、または実行待ち |
| S | sleeping | 待機中(イベントを待っている) |
| I | idle | アイドル状態のカーネルスレッド |
| D | uninterruptible sleep | 割り込めない待機。主にディスク入出力待ち |
| T | stopped | ジョブ制御シグナルで停止中 |
| t | traced | デバッガによる停止中 |
| Z | zombie | 終了済みで、親の後始末待ち |
Linux の load average は、R の数に加えて D(入出力待ち)の数も含めて計算されます。CPUが空いているのに load average が高いときは、D 状態のプロセスと wa を確認します。
操作キー早見表
top を起動したまま押すキーです。大文字と小文字は別のキーとして扱われます。「確認」の列は、今回 tmux 上で実際に押して表示の変化を確かめたものに ○ を付けています。
並べ替え
| キー | 動作 | 確認 |
|---|---|---|
| P | %CPU の高い順(初期状態) | ○ |
| M | %MEM の高い順 | ○ |
| T | TIME+ の長い順 | ○ |
| N | PID の大きい順 | ○ |
| R | 昇順と降順を入れ替える | ○ |
| < / > | ソート列を左・右の列へ移す | ○ |
| x | ソート中の列を強調表示する | ○ |
| f → s | 一覧から任意の列をソート列に指定する | ○(画面表示まで) |
表示の切り替え
| キー | 動作 | 確認 |
|---|---|---|
| 1 | コアごとのCPU使用率を表示(%Cpu0、%Cpu1 …) | ○ |
| t | CPU行の表示形式を切り替え(数値 → バー → 非表示) | ○ |
| m | メモリ行の表示形式を切り替え(数値 → バー → 非表示) | ○ |
| E | ヘッダーのメモリ単位を切り替え(KiB → MiB → GiB …) | ○ |
| e | プロセス欄のメモリ単位を切り替え(2828 → 2.8m など) | ○ |
| c | コマンド名と、引数つきコマンドラインを切り替え | ○ |
| V | 親子関係のツリー表示 | ○ |
| H | スレッド単位の表示 | ○ |
| i | CPUを使っていないプロセスを隠す | ○ |
| 0 | 値が 0 の欄を空白にする | ○ |
| I | Irixモード(1コア=100%)の入/切 | ○ |
| z / b | 色つき表示/太字と反転の切り替え | 未実行 |
絞り込み・操作・設定
| キー | 動作 | 確認 |
|---|---|---|
| u | ユーザー名で絞り込み(空欄で解除) | ○ |
| o | 条件で絞り込み(例:COMMAND=mysqld)。= で解除 | ○ |
| n | 表示する行数を指定(0 で無制限) | ○ |
| L | 文字列を検索して位置づけ(& で次を検索) | ○(入力まで) |
| d | 更新間隔(秒)を変更 | ○(入力欄の表示まで) |
| k | シグナルを送る(PID とシグナルを入力) | ○(入力欄の表示まで) |
| r | nice値を変更(PID と値を入力) | ○(入力欄の表示まで) |
| f | 表示する列の選択画面を開く | ○ |
| W | 現在の設定を保存 | ○ |
| h または ? | ヘルプ | ○ |
| q | 終了(入力の取り消しは Esc) | ○ |
キーを押したときの画面の変化(実行結果)
1 キーを押すと、3行目がコアごとの行に分かれます。全体では約50%でも、1コアが張り付いていることがわかります。
%Cpu0  : 36.9 us, 11.9 sy,  0.0 ni, 48.8 id,  0.0 wa,  0.0 hi,  2.4 si,  0.0 st
%Cpu1  :  1.2 us,  0.0 sy, 98.8 ni,  0.0 id,  0.0 wa,  0.0 hi,  0.0 si,  0.0 st
t キーと m キーでは、数値の行がバー表示に変わります。
%Cpu(s):  55.0/0.0    55[||||||||||||||||||||||||||||||||||||||||                 ]
MiB Mem : 14.3/8031.1   [|||||||||||                                              ]
e キーでプロセス欄のメモリが読みやすい単位になります。
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
 2360 root      20   0 4055.3m 100.4m  35.0m S  99.2   1.2   0:01.44 java
 2121 root      35  15    2.8m   1.8m   1.7m R  91.7   0.0   0:29.47 sh
V キーのツリー表示では、子プロセスが `- で字下げされます(抜粋)。
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
    1 root      20   0   22492   5312   4908 S   0.0   0.1   0:00.73 process_api
   77 root      20   0    2824   1840   1704 S   0.0   0.0   0:00.00  `- sh
 2200 root      20   0    5096   3736   3300 S   0.0   0.0   0:00.00      `- zsh
k キーを押すと、プロセス欄の上に入力欄が出ます。既定の PID は一覧の先頭のプロセスです。
PID to signal/kill [default pid = 2121]
PID を入力して Enter を押すと、次に送るシグナルを聞かれます(何も入力しなければ 15=SIGTERM)。押し間違えたときは Esc で取り消せます。
o キーの絞り込みは「列名=値」の形で入力します。
add filter #1 (ignoring case) as: [!]FLD?VAL
ここで COMMAND=mysqld と入力すると、mysqld の行だけになりました。
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
  581 mysql     25   5 1806720 437724  37212 S   0.0   5.3   0:04.00 mysqld
 2697 mysql     25   5 1782132 400184  36864 S   0.0   4.9   0:00.81 mysqld
f キーで列を追加する
f を押すと列の管理画面が開きます。先頭に * が付いた列が表示中です。
Fields Management for window 1:Def, whose current sort field is %CPU
   Navigate with Up/Dn, Right selects for move then <Enter> or Left commits,
   'd' or <Space> toggles display, 's' sets sort.  Use 'q' or <Esc> to end!

* PID      = P  PPID     = P  nTH      = N  SUPGIDS  = S  nsPID    = P  RSS      = R
* USER     = E  UID      = E  P        = L  SUPGRPS  = S  nsUSER   = U  PSS      = P
* PR       = P  RUID     = R  TIME     = C  TGID     = T  nsUTS    = U  PSan     = P
| よく追加する列 | 内容 |
|---|---|
| PPID | 親プロセスのPID |
| nTH | スレッド数 |
| P | 最後に使ったCPUコアの番号 |
| SWAP | スワップに出ている量 |
| USED | RES + SWAP |
| ioR / ioW | 読み込み・書き込みのバイト数 |
上下キーで列を選び、d またはスペースで表示の入/切、s でソート列に指定、q か Esc で戻ります。使える列名の一覧は top -O でも出力できます。
W キーで設定を保存する
W を押すと、並び順・表示列・単位などが設定ファイルに保存され、次回の起動時にも同じ表示になります。今回の環境では、次の場所に書き出されました(ホームディレクトリの部分は環境に合わせて置き換えています)。
Wrote configuration to '/home/taro/.config/procps/toprc'
初期状態に戻したいときは、このファイルを削除します。
load average の見方:コア数で割って判断する
load average は「CPUを使いたい、または入出力を待っているプロセスの平均数」です。 そのままの数値ではなく、コア数で割って判断します。
コア数は nproc で確認できます。次のワンライナーは、直近1分の値をコア数で割って表示します。
awk -v c="$(nproc)" '{printf "load1=%s cores=%d per_core=%.2f\n", $1, c, $1/c}' /proc/loadavg
load1=4.25 cores=2 per_core=2.12
| コアあたりの値 | 状態の目安 | 次の行動 |
|---|---|---|
| 0.7 未満 | 余裕がある | そのままでよい |
| 0.7〜1.0 | ほぼ使い切り | 増加傾向かどうかを見守る |
| 1.0〜2.0 | 順番待ちが発生 | P でCPU上位、wa の値を確認 |
| 2.0 以上が続く | 待ちが長い | 原因プロセスの特定と対処を進める |
この表は一般的に使われる目安で、処理の性質によって許容範囲は変わります。あわせて、3つの数字の並びで傾向を読みます。
| 1分・5分・15分の並び | 読み取れること |
|---|---|
| 5.52, 1.89, 0.67(左が大きい) | いま混み始めたところ |
| 0.80, 2.50, 4.10(右が大きい) | 混雑は落ち着きつつある |
| 3.00, 3.10, 2.90(ほぼ同じ) | 一定の負荷が続いている |
症状別:wa・st・メモリが気になるときの次の一手
top は「何かが起きている」ことを知らせてくれます。原因の深掘りは、専用のコマンドに引き継ぎます。
| top での見え方 | 考えられる状況 | 次に打つコマンド |
|---|---|---|
| us が高い、id が低い | アプリの計算処理が多い | top で P、1 でコア別、H でスレッド別 |
| sy が高い | システムコールやプロセス切り替えが多い | vmstat 1 の cs(コンテキストスイッチ)と in |
| wa が高い | ディスクの入出力待ち | iostat -x 1 の %util と await、vmstat 1 の b 列 |
| st が高い | 仮想化ホスト側でCPUを待たされている | vmstat 1 の st 列で継続を確認。インスタンスの種類や配置を見直す |
| avail Mem が小さい | メモリが不足気味 | top で M、free -m、スワップの used |
| Swap used が増え続ける | 物理メモリが足りず退避が続く | vmstat 1 の si / so |
| load average は高いが id も高い | 入出力待ち(D状態)が多い | top の S 列で D を探す、iostat -x 1 |
| zombie が増え続ける | 親プロセスが後始末をしていない | top で f から PPID を追加し親を確認 |
vmstat で続けて観察する
vmstat 1 3
procs -----------memory---------- ---swap-- -----io---- -system-- -------cpu-------
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st gu
 0  0      0 4288656  69060 2543116    0    0  3064  4903 1835   17 19  3 60 18  0  0
 0  0      0 4303852  69064 2544500    0    0   812   368 1308 2238 16  4 67 12  0  0
 1  0      0 4305016  69064 2544560    0    0     0     0 1468 1962  4  2 94  0  0  0
| 列 | 意味 | wa が高いときの見方 |
|---|---|---|
| r | 実行待ちのプロセス数 | コア数を超え続けるとCPU不足 |
| b | 入出力待ちで止まっているプロセス数 | 0 でない状態が続くとディスク待ち |
| si / so | スワップからの読み込み・書き出し | 0 以外が続くとメモリ不足 |
| bi / bo | ブロックデバイスの読み・書き | 大きいときに wa が上がりやすい |
| wa / st | top の3行目と同じ | 1秒ごとの推移を見られる |
1行目は起動時からの平均なので、2行目以降を見ます。上の例では wa が 18 → 12 → 0 と下がっていき、bi・bo も同時に小さくなっています。入出力が落ち着くと wa も下がる、という関係が読み取れます。
iostat でデバイスを特定する
iostat -x 1 2
sysstat パッケージに含まれるコマンドです。%util(デバイスの稼働率)が100%近く、await(1回の入出力にかかる時間)が大きいデバイスが、待ちの原因になっています。今回の環境は入出力が落ち着いたあとに実行したため、全デバイスの値が 0.00 でした。数値の読み方は一般に知られている仕様に沿って説明しています。
オプションとコピペ用の実行例
| オプション | 意味 | 例 |
|---|---|---|
| -b | バッチモード(画面制御なしで出力) | top -b -n 1 |
| -n 回数 | 指定回数だけ更新して終了 | top -b -n 3 |
| -d 秒 | 更新間隔 | top -d 1 |
| -o 列名 | 指定した列でソート | top -o %MEM |
| -p PID | 指定したPIDだけ表示(カンマ区切りで複数) | top -p 2121 |
| -u ユーザー | 指定ユーザーのプロセスだけ | top -u mysql |
| -H | スレッド単位で表示 | top -H -p 2121 |
| -c | コマンドラインを引数つきで表示 | top -c |
| -w 幅 | 出力の横幅を指定 | top -b -n 1 -c -w 200 |
| -E 単位 | ヘッダーのメモリ単位(k, m, g …) | top -E g |
| -e 単位 | プロセス欄のメモリ単位 | top -e m |
| -1 | コア別表示の入/切を反転 | top -1 |
| -i | アイドルのプロセスを隠す | top -i |
| -O | 使える列名の一覧を出力して終了 | top -O |
1回だけ出力して上位を見る
top -b -n 1 | head -n 12
ヘッダー5行、空行、見出し行のあとに、プロセスが上位5件表示されます。
メモリ使用量の多い順に、引数つきで保存する
top -b -n 1 -o %MEM -c -w 160 | head -n 12 > snap.txt
実行後、snap.txt は12行になりました。バッチモードでは横幅が既定で切り詰められるため、-c を使うときは -w で幅を広げるとコマンドラインが途中で切れにくくなります。-w なしと -w 120 の違いは次のとおりです。
 2121 root      35  15    2828   1856   1728 R 100.0   0.0   0:02.32 sh
 2121 root      35  15    2828   1856   1728 R  90.0   0.0   0:02.90 sh -c while :; do :; done
メモリ順の上位と単位の指定
top -b -n 1 -e m -o RES | sed -n 7,9p
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
  581 mysql     25   5 1764.4m 427.5m  36.3m S   9.1   5.3   0:03.77 mysqld
ヘッダー側は -E で変えられます。
top -b -n 1 -E g | sed -n 4,5p
GiB Mem :      7.8 total,      4.0 free,      1.7 used,      2.5 buff/cache
GiB Swap:      0.0 total,      0.0 free,      0.0 used.      6.2 avail Mem
特定のユーザー・プロセスだけを見る
top -b -n 1 -u root | sed -n 7,9p
top -b -n 1 -p 2121 | tail -n 2
  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
 2121 root      35  15    2828   1856   1728 R 100.0   0.0   0:03.31 sh
スレッド単位で見る
top -b -n 1 -H | head -n 9
top - 13:32:01 up 5 min,  0 user,  load average: 5.52, 1.89, 0.67
Threads: 148 total,   4 running, 144 sleeping,   0 stopped,   0 zombie
2行目が Threads になり、73個のタスクが148個のスレッドとして数えられています。-H のときの PID 列はスレッドIDで、COMMAND にはスレッド名が出ます。1つのプロセスのどのスレッドがCPUを使っているかを調べるときは top -H -p PID の形が便利です。
一定間隔で記録を残す
top -b -d 5 -n 3 > top.log
5秒おきに3回分を top.log に書き出します。-n 2 で実行して「top -」で始まる行を数えると 2 になり、指定した回数だけ出力されることを確認できました。
バッチモードで覚えておきたいのは、1回目のCPU使用率は、ごく短い間隔で測った値になることです。実際に2回分を並べると、1回目と2回目で大きく違いました。
top -b -n 2 -d 1 | grep '^%Cpu'
%Cpu(s): 25.0 us, 10.0 sy,  0.0 ni, 65.0 id,  0.0 wa,  0.0 hi,  0.0 si,  0.0 st
%Cpu(s):  8.2 us,  0.5 sy,  0.0 ni, 90.4 id,  0.0 wa,  0.0 hi,  0.9 si,  0.0 st
CPU使用率を記録したいときは -n 2 以上にして、2回目以降の値を使うと安定します。
htop・btop との対応表
top は多くのLinuxに最初から入っています。htop と btop は追加で入れるツールで、色つきのバーやマウス操作に対応しています。今回は htop 3.3.0 と btop 1.3.0 を起動して画面を確認しました。
htop の画面上部(実行結果):
    0[||||||||||||||||||||||||||||||||||||||||||93.3%] Tasks: 28, 152 thr, 57 kthr; 2 running
    1[||||||||||||||||||||||||||||||||||||||||||87.2%] Load average: 3.77 2.16 0.87
  Mem[||||||||||||||||||||||||||          1.53G/7.84G] Uptime: 00:06:34
  Swp[                                          0K/0K]

  PID USER       PRI  NI  VIRT   RES   SHR S  CPU%-MEM%   TIME+  Command
F1Help  F2Setup F3SearchF4FilterF5Tree  F6SortByF7Nice -F8Nice +F9Kill  F10Quit
| やりたいこと | top | htop(3.3.0で確認) | btop(1.3.0) |
|---|---|---|---|
| CPU順に並べる | P | P | 画面に cpu の並び順表示あり(キー操作は未実行) |
| メモリ順に並べる | M | M | 未実行 |
| ソート列を選ぶ | f → s、< / > | F6(SortBy) | 未実行 |
| ツリー表示 | V | t または F5 | 画面に tree の項目あり(キー操作は未実行) |
| スレッド表示の切り替え | H | H | 未実行 |
| コア別のCPU | 1 | 最初からコア別のバー | 最初からコア別(C0、C1)で表示 |
| 絞り込み | u、o | F4(Filter)、F3(Search) | 画面に filter の項目あり(キー操作は未実行) |
| シグナルを送る | k | F9(Kill) | 画面に kill・signals の項目あり(キー操作は未実行) |
| nice値を変える | r | F7 / F8 | 未実行 |
| 設定 | f、W で保存 | F2(Setup) | 画面に menu の項目あり(キー操作は未実行) |
| 1回だけ出力(スクリプト用) | top -b -n 1 | 向かない(対話用) | 向かない(対話用) |
| 終了 | q | q または F10 | q |
htop の P・M・t・H・F6 は実際に押して、ソート列の印や表示が変わることを確認しました。btop は起動して、CPU・メモリ・ネットワーク・プロセスの4つの枠が表示されるところまでを確認しています。
| ツール | 向いている場面 |
|---|---|
| top | どのサーバーでもすぐ使いたい、ログに残したい、スクリプトから呼びたい |
| htop | 対話的に調べたい、マウスやファンクションキーで操作したい |
| btop | CPU・メモリ・ネットワーク・ディスクをグラフでまとめて眺めたい |
つまずきやすいポイント
| 気になったこと | 理由 | 対応 |
|---|---|---|
| %CPU が 100 を超えている | 1コア=100%で数えるため。複数コアを使うと 200、400 になる | I キーで全コア合計を100%とする表示に切り替えられる |
| free が小さくて不安 | キャッシュに使われているだけのことが多い | avail Mem を見る |
| 3行目の us は低いのに1つのプロセスが 100% | 3行目は全コアの平均 | 1 キーでコア別に見る |
| 前回と並び順や列が違う | W で保存した設定が読み込まれている | ~/.config/procps/toprc を確認 |
| top -b の出力でコマンドが途中で切れる | バッチモードの横幅の既定値 | -w で幅を指定 |
| top -b -n 1 のCPU使用率が毎回ばらつく | 1回目は短い間隔の測定値 | -n 2 にして2回目を使う |
| 大文字のキーが効かない | 大文字と小文字は別のキー | Shift を押しながら入力、Caps Lock を確認 |
| k で終了できない | 他ユーザーのプロセスには権限が必要 | 所有者か管理者権限で実行する |
よくある質問
Q. load average がいくつなら対応が必要ですか? A. コア数で割った値が目安です。1.0 を超える状態が続くなら順番待ちが発生しているので、P でCPU上位のプロセス、3行目の wa を確認します。一時的に超えるだけなら、5分・15分の値と見比べて傾向を判断します。
Q. メモリの free がほとんどありません。増設が必要ですか? A. まず avail Mem を見てください。buff/cache は必要に応じて解放されるため、avail Mem に余裕があれば問題ありません。avail Mem が小さく、Swap の used が増え続けているときに、メモリの追加や設定の見直しを検討します。
Q. VIRT がとても大きいプロセスがあります。問題ですか? A. VIRT は予約した範囲の合計で、実際に使っている物理メモリは RES です。VIRT が数GiB〜数十GiBでも、RES が小さければメモリを圧迫していません。今回の環境でも、VIRT が 25.0g、RES が約190MiB のプロセスがありました。
Q. top の結果をファイルに保存するには? A. バッチモードを使い、top -b -n 1 > ファイル名 の形でリダイレクトします。対話モードのままリダイレクトすると画面制御用の文字が混ざるため、-b を付けます。
まとめ
- top はヘッダー5行で全体、プロセス欄で内訳を読む。ヘッダーで傾向をつかんでから原因のプロセスを探す
- load average はコア数で割って判断する。1.0 を超える状態が続くと順番待ち。1分・5分・15分の並びで増減の傾向もわかる
- メモリの余裕は avail Memで見る。プロセスごとのメモリは VIRT ではなく RES
- PR = 20 + NI。%CPU は1コア=100%、TIME+ はCPU時間の累計
- 操作キーは P・M・T でソート、1 でコア別、c で引数、V でツリー、H でスレッド、f で列選択、W で保存
- wa が高いときは iostat -x 1、st や推移を見たいときは vmstat 1 に引き継ぐ
- 記録やスクリプトには top -b -n 1。CPU使用率を使うなら -n 2 にして2回目の値を採用する
本記事の内容は、ご自由にお使いください。
ご利用の際は、出典として本ページへのリンクを記載いただけますようお願いします。
(記載例)出典:株式会社RJC「Linux topコマンドの見方 全項目の意味と操作キー早見表」
株式会社RJCでは、topコマンドの読み方のようなLinuxの基礎を仲間と学び合っています。こうした知識を共有しながら、日々技術を磨いています。
株式会社RJC ― SI事業・SES事業・AI駆動開発。RJCは一緒に成長を楽しめる会社です。
WE ARE HIRING
RJCで一緒に開発しながら、
成長を楽しみませんか?
RJCは、Web・モバイル・AIを活用した開発プロジェクトで、テックリードやPM・PMOも活躍するシステム開発会社です。会社を知る、待遇を確かめる、話を聞いてみる。気になるところ見てみてください!
- 127日年間休日
- 12時間平均残業時間
- 毎日ガチャ遊びココロも大切にする福利厚生。アマギフなどの賞品ラインナップ!
ほかにも、チケットレストラン、書籍読み放題、2年ごとの慰労報奨(休暇 or 金一封)、11期連続の黒字決算。